 EN
 RO
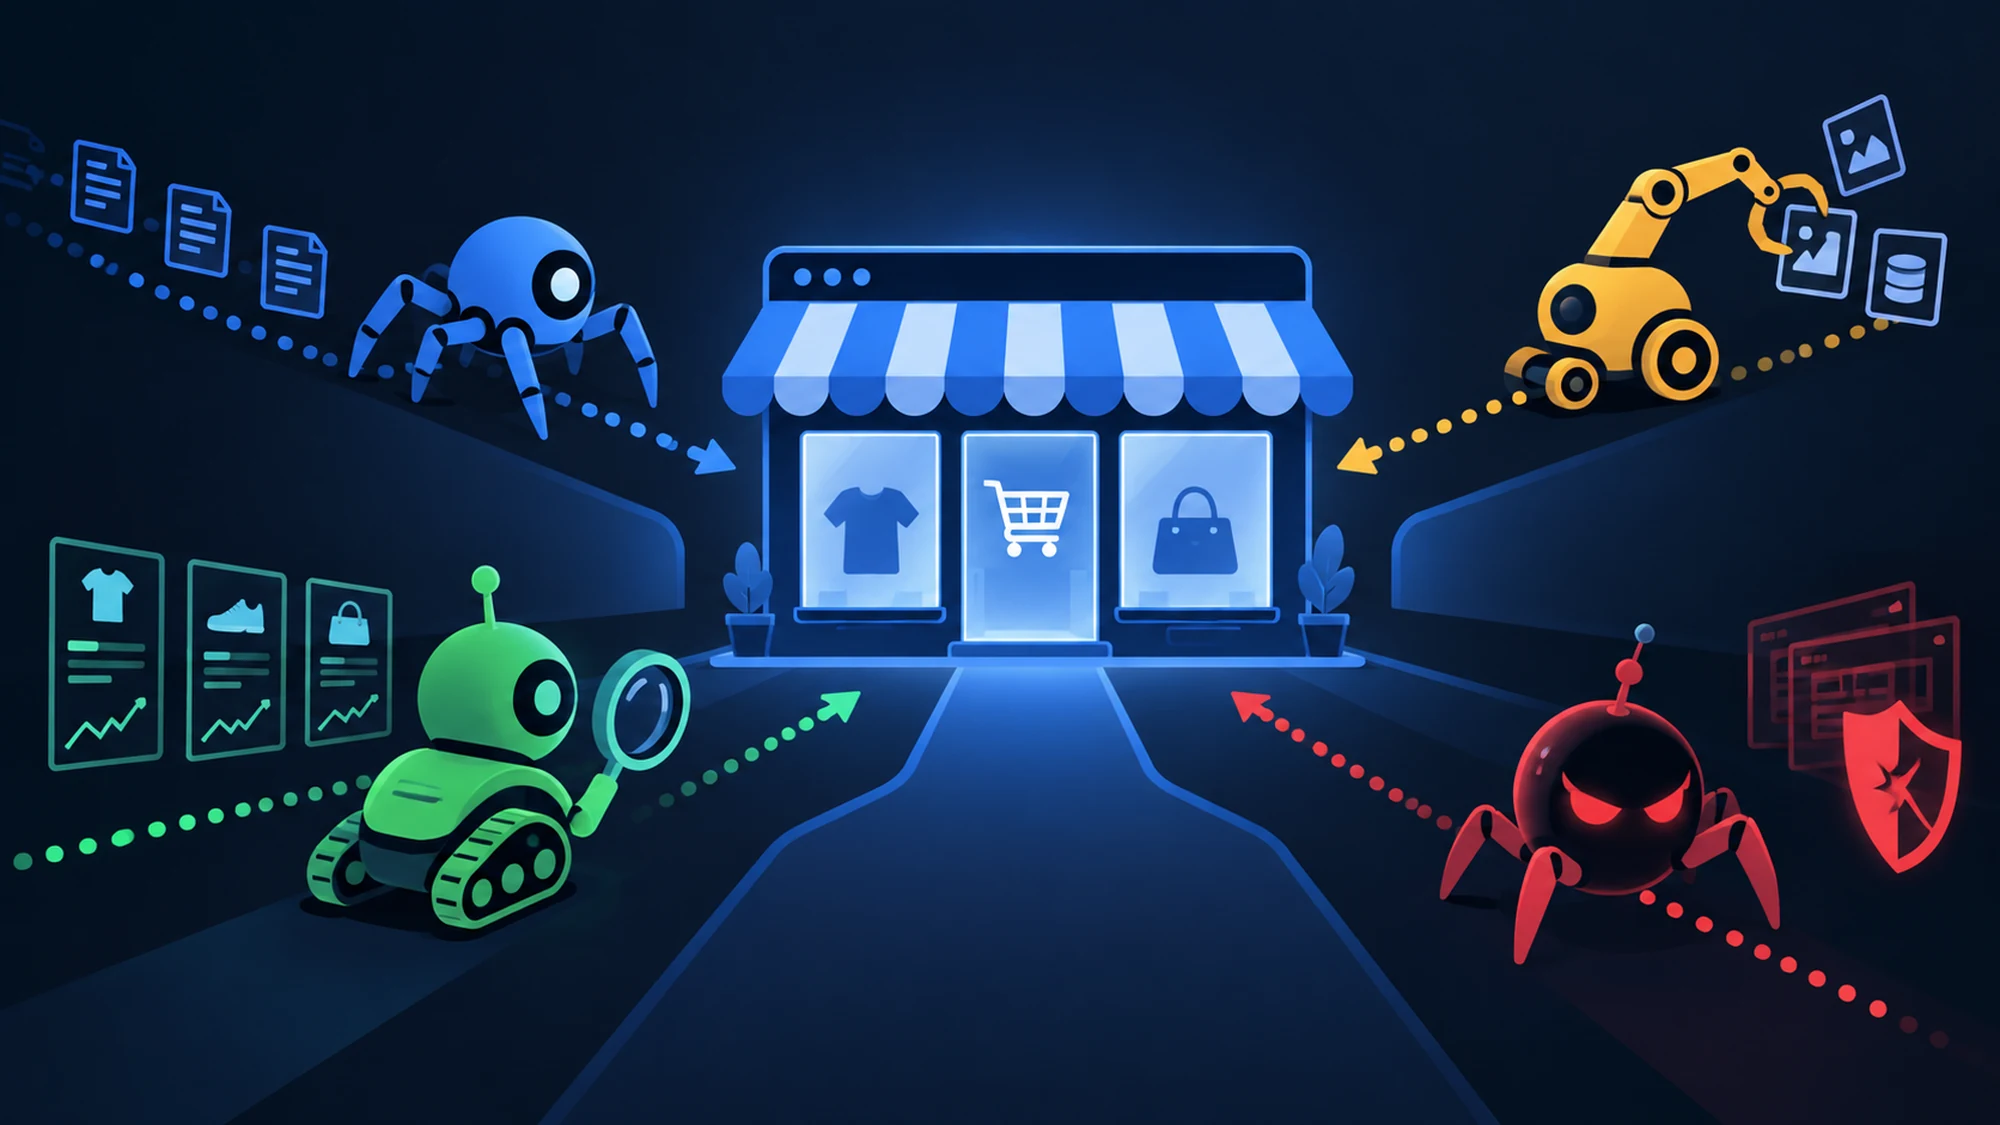
Nu orice bot care îți vizitează site-ul e Googlebot venit să te indexeze. Pe orice magazin online ajung, zilnic, mai multe tipuri de crawlere, fiecare cu un rol diferit: unele indexează pagini pentru căutare, altele monitorizează prețuri pentru competitori, altele extrag date de produs pentru propriile cataloage, iar unele nu au niciun scop legitim. Confuzia dintre aceste roluri duce fie la blocarea din greșeală a unui bot util (cu impact direct în SEO), fie la ignorarea unui bot care îți fură marja prin monitorizare agresivă de prețuri.
Articolul explică cele patru roluri principale pe care le poate avea un crawler care ajunge pe un magazin online, cum diferă exact de Googlebot ca scop și comportament, și ce pași practici ai la dispoziție ca să le deosebești pe ale tale, direct din log-urile serverului sau din analytics.
Contextul e relevant mai ales dacă administrezi un eCommerce cu trafic mixt de boți sau dacă ai observat deja vizite anormale în log-uri și nu știi dacă e vorba de SEO crawling, de un concurent care îți urmărește prețurile sau de ceva mai puțin dorit.
Ce face, de fapt, Googlebot — și de ce nu e "un crawler ca oricare altul"
Googlebot este crawlerul folosit de Google pentru a descoperi și indexa pagini web, cu un singur scop: să adune conținut pe care motorul de căutare să îl poată afișa în rezultate. Vizitează pagini, urmărește linkuri interne, citește conținutul text și structura HTML, apoi trimite aceste informații mai departe către algoritmii de indexare și ranking.
Comportamentul lui e predictibil și documentat public: respectă strict fișierul robots.txt, folosește un user-agent identificabil ("Googlebot") și poate fi verificat oficial prin căutare inversă DNS a IP-ului de la care vine cererea. Nu extrage date de produs într-un format structurat pentru refolosire externă — indexează pagina ca întreg, pentru scopul de căutare.
Rolul 1: crawlere de indexare (Googlebot și echivalente)
Din această categorie fac parte Googlebot, dar și Bingbot, sau crawlerele altor motoare de căutare mai puțin folosite în România. Scopul lor este identic: descoperire de conținut pentru afișare în rezultatele de căutare. Pentru un magazin online, acest tip de crawler este de dorit — fără el, paginile de produs nu ajung deloc vizibile organic în Google.
Blocarea accidentală a acestor boți (de exemplu, printr-o regulă prea agresivă în robots.txt sau un firewall configurat greșit) taie direct vizibilitatea organică a magazinului, uneori fără ca administratorul să observe imediat cauza scăderii de trafic.
Rolul 2: crawlere de monitorizare a prețurilor și a competiției
Acest tip de bot vizitează periodic paginile de produs ale unui magazin și extrage exact prețul, stocul și, uneori, disponibilitatea — nu conținutul întreg al paginii. Poate aparține unui competitor direct, unei unelte de price intelligence folosite de o agenție, sau chiar propriei companii, dacă rulează un proiect de monitorizare a pieței.
Diferența față de Googlebot este de scop și de frecvență: acest crawler nu caută să indexeze pagina pentru căutare, ci să extragă un câmp foarte precis, repetat la intervale scurte (de multe ori de câteva ori pe zi, nu o dată la câteva zile ca la reindexare). O frecvență foarte mare de vizitare a acelorași pagini de produs, fără pattern de navigare tipic uman, este un semn clar al acestui rol.
Rolul 3: crawlere de extragere a datelor de catalog (business crawling)
Acesta este rolul din spatele serviciilor de crawling folosite pentru populare automată de cataloage, generare de feed-uri de produse (Google Shopping, marketplace-uri) sau agregare de conținut din surse multiple. Scopul nu este indexarea pentru căutare, ci transformarea datelor publice de pe o pagină într-un format structurat (Excel, bază de date, feed XML/CSV) reutilizabil de un alt sistem.
Un astfel de crawler, construit corect, respectă robots.txt, folosește un user-agent propriu identificabil și impune pauze controlate între cereri, exact ca un vizitator responsabil, nu ca un atac. Poți citi mai în detaliu cum funcționează pas cu pas un astfel de script în ghidul dedicat pașilor unui bot de crawling.
Rolul 4: bot-uri fără scop legitim (scraping agresiv, atacuri automate)
Nu toate boții care ajung pe un magazin online au un scop declarat sau util pentru site. Această categorie include scraping agresiv de conținut (copiere integrală a descrierilor și imaginilor, fără nicio limitare de rată), boți de tip credential stuffing care testează combinații de user/parolă pe pagina de login, sau boți care încearcă să exploateze formulare de contact sau de checkout pentru spam automat.
Semnul distinctiv al acestei categorii este comportamentul agresiv: mii de cereri într-un interval scurt, ignorarea completă a robots.txt, user-agent falsificat (deghizat ca browser obișnuit) și, adesea, IP-uri rotative din surse necunoscute.
Tabel comparativ: cele patru roluri de crawler
| Rol | Scop | Comportament tipic | Cum reacționezi |
|---|---|---|---|
| Indexare (Googlebot etc.) | Afișare în căutare organică | Respectă robots.txt, user-agent verificabil, frecvență moderată | Permite explicit, nu bloca |
| Monitorizare prețuri | Urmărire preț/stoc competitor | Vizite frecvente pe aceleași pagini de produs | Observă, decide dacă limitezi sau accepți |
| Extragere date catalog | Populare catalog, feed-uri, agregare | User-agent propriu, rate limiting, respectă robots.txt | Permite dacă e proiect legitim, cu acord |
| Scraping agresiv / atac | Fără scop legitim declarat | Volum mare, robots.txt ignorat, user-agent falsificat | Blochează (rate limiting, WAF, IP blocking) |
Cum deosebești boții în log-urile propriului site
Nu ai nevoie de unelte complicate pentru o primă verificare — informația e deja în log-urile serverului sau într-un instrument de analytics care înregistrează user-agent și IP.
- Verifică user-agent-ul declarat — un bot legitim se identifică de regulă clar ("Googlebot", "Bingbot" sau numele propriu al unui serviciu de crawling).
- Confirmă prin IP, nu doar prin nume — pentru Googlebot, Google publică metoda oficială de verificare prin căutare inversă DNS a IP-ului; un user-agent care pretinde a fi Googlebot, dar vine de pe un IP care nu aparține Google, este suspect.
- Urmărește frecvența și pattern-ul de navigare — vizite repetate, la intervale scurte, pe aceleași pagini de produs (fără parcurgere de categorii sau alte secțiuni) indică monitorizare de preț, nu indexare.
- Verifică dacă respectă robots.txt — un bot care accesează în continuare pagini excluse explicit prin robots.txt nu se comportă ca un crawler responsabil.
Riscuri frecvente și cum le eviți
Cel mai frecvent risc nu este prezența unui bot, ci reacția greșită la el.
- Blocarea accidentală a Googlebot — o regulă prea largă în robots.txt sau un firewall configurat pe user-agent poate exclude, fără să vrei, și crawlerul de indexare. Consecința e scăderea vizibilității organice, uneori observată abia după săptămâni. Mitigare: testează orice regulă nouă în Google Search Console înainte de a o publica live.
- Ignorarea completă a monitorizării de preț — dacă un competitor extrage constant prețurile tale fără să observi, poți pierde marjă fără să știi de ce vânzările scad pe anumite produse. Mitigare: urmărește periodic log-urile pentru pattern-uri repetitive pe paginile de produs.
- Blocarea tuturor boților, inclusiv a celor utile — o soluție de securitate prea agresivă poate bloca și un serviciu de crawling legitim, comandat chiar de tine pentru populare de catalog sau generare de feed. Mitigare: whitelist explicit pentru user-agent-ul propriului furnizor de crawling.
Checklist practic de gestionare a boților pe un magazin online
- Ai un fișier
robots.txtactualizat, care permite explicit boții de indexare? - Ai verificat vreodată log-urile serverului pentru trafic de bot neobișnuit?
- Știi să deosebești un user-agent real de unul falsificat (verificare IP)?
- Ai rate limiting configurat pentru cereri excesive, fără să afecteze traficul uman?
- Ai un whitelist pentru boții legitimi pe care îi folosești tu însuți (crawling comandat)?
Întrebări frecvente despre rolurile de crawler
Cum știu sigur că un bot este chiar Googlebot și nu unul deghizat?
User-agent-ul declarat nu este suficient, pentru că poate fi copiat de oricine. Metoda sigură este verificarea IP-ului prin căutare inversă DNS, conform metodei oficiale publicate de Google; dacă IP-ul nu aparține rețelei Google, botul nu este Googlebot real, indiferent ce user-agent declară.
Un crawler de monitorizare a prețurilor este ilegal?
Nu în mod automat — depinde de ce date extrage, cât de agresiv se comportă și dacă respectă termenii site-ului țintă și robots.txt. Pentru situații neclare din punct de vedere legal, recomandăm consultarea unui specialist, mai ales dacă sunt implicate date cu caracter personal.
Dacă blochez toți boții necunoscuți, sunt mai în siguranță?
Nu neapărat. Riști să blochezi și boți utili (indexare, servicii de crawling comandate de tine) dacă regulile nu sunt specifice. O abordare mai eficientă este identificarea explicită a boților doriți (whitelist) și limitarea, nu blocarea completă, a restului traficului suspect.
De ce văd în log-uri boți care pretind că sunt Googlebot, dar vin din IP-uri diferite?
Este un semn comun de user-agent falsificat, folosit fie pentru a evita blocaje, fie de boți cu scop neclar. Verificarea prin IP rămâne singura metodă de confirmare corectă.
Concluzie
Un magazin online primește vizite de la cel puțin patru tipuri de crawlere, cu roluri complet diferite: indexare pentru căutare, monitorizare de preț, extragere structurată de date pentru cataloage și, uneori, scraping fără scop legitim. Confuzia dintre Googlebot și celelalte roluri duce fie la pierderea vizibilității organice, fie la ignorarea unor riscuri reale pentru marjă și securitate. Diferența se face prin verificare — user-agent, IP, frecvență, respectarea robots.txt — nu prin presupuneri.
Dacă vrei un crawler personalizat, construit corect din start (respectă robots.txt, rate limiting, livrare în formatul cerut) pentru monitorizare de preț sau populare de catalog, contactează-ne pentru o ofertă adaptată exact sursei tale de date. Vezi și detaliile complete ale serviciului nostru de preluare date online prin crawling.
Imagine generată cu AI, folosită în scop ilustrativ.
Scrie un comentariu