 EN
 RO
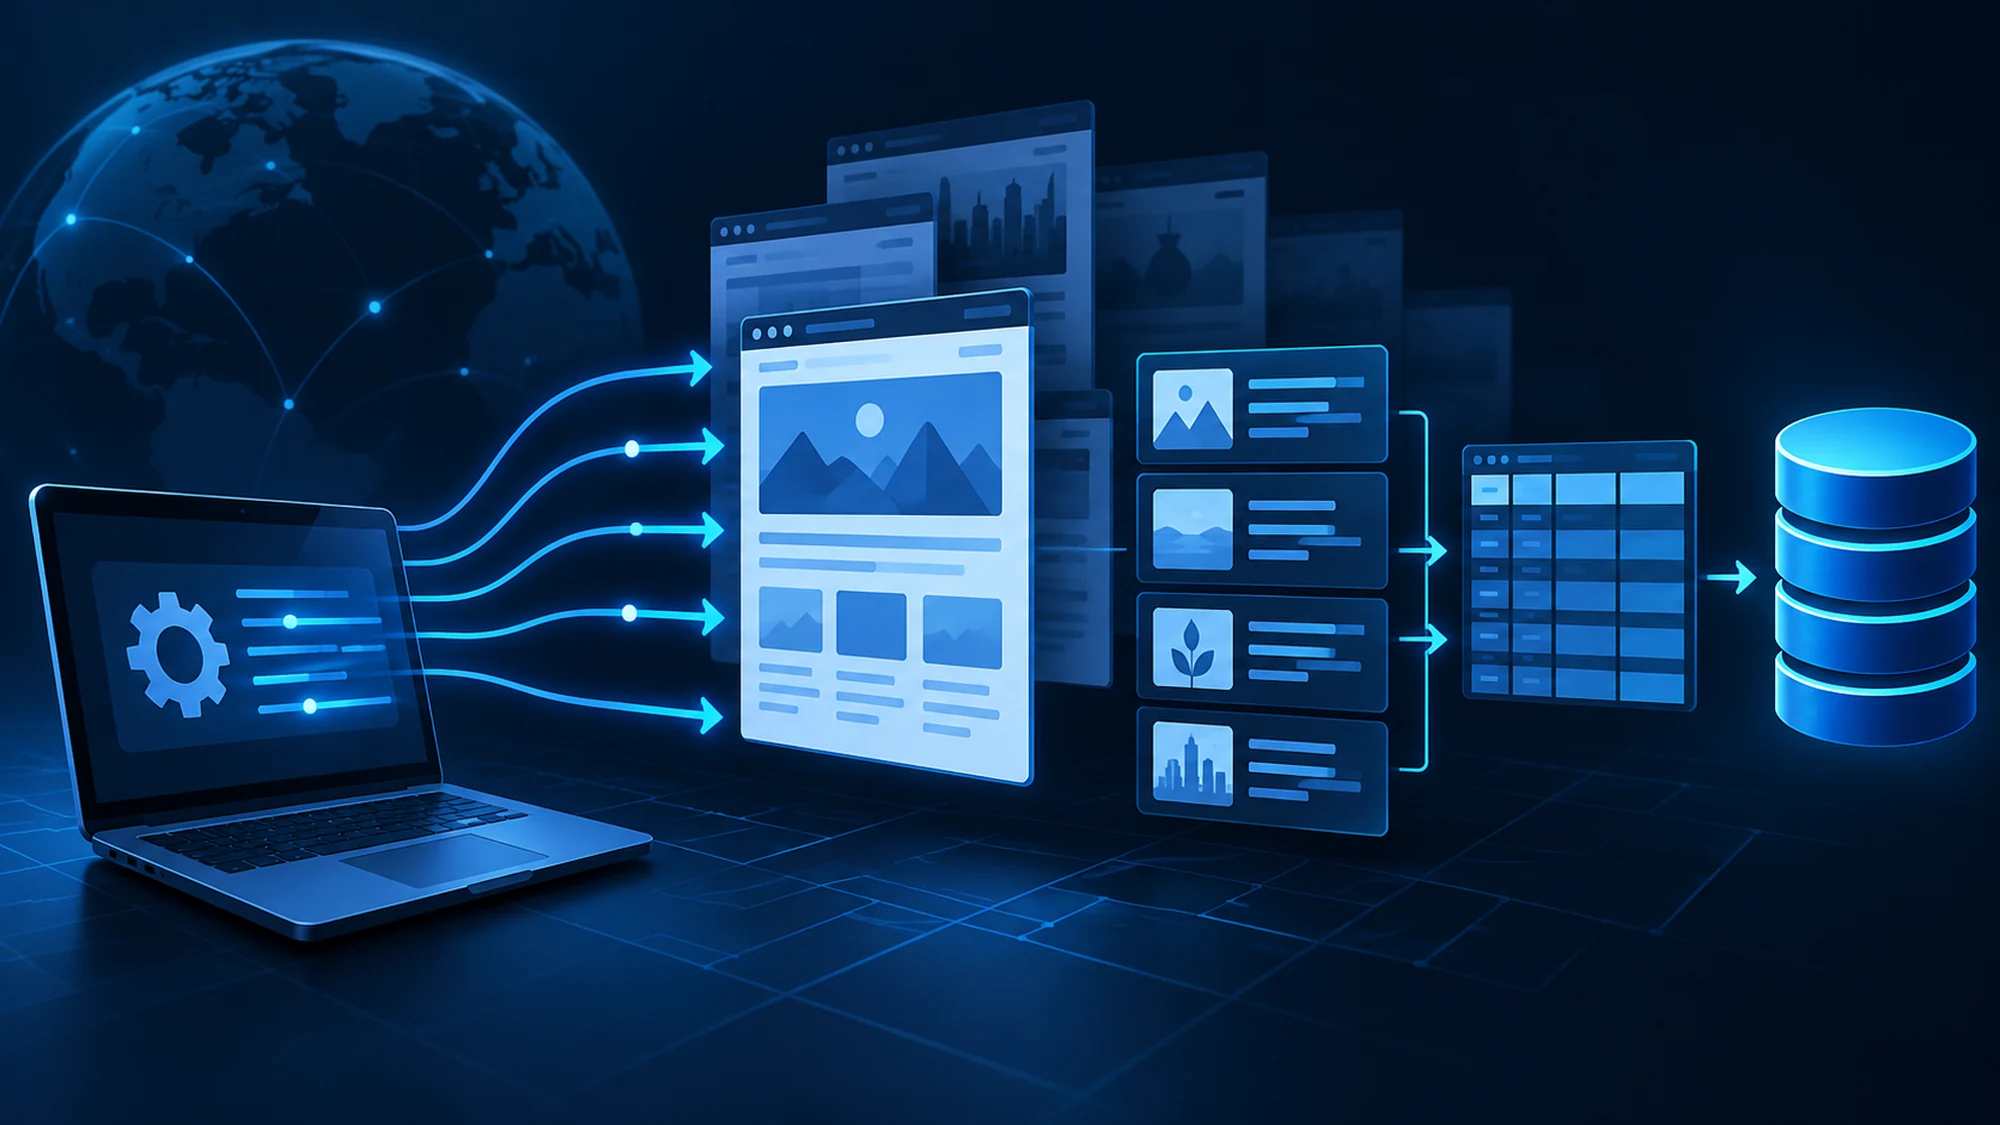
Un bot de crawling funcționează în cinci pași repetitivi: trimite o cerere către o pagină web, descarcă răspunsul, extrage informațiile relevante din codul paginii, le pune într-un format structurat (tabel, bază de date, fișier) și trece la pagina următoare. Nu este magie și nu este un proces "inteligent" în sine — este un script care repetă acești pași de mii de ori pe oră, mult mai rapid și mai constant decât ar putea-o face o persoană manual.
Termenul poate suna abstract dacă nu ai lucrat direct cu așa ceva, dar mecanismul din spate este simplu de urmărit odată descompus în pași. În acest articol trecem prin fiecare etapă a unui script de crawling, de la prima cerere trimisă către un site până la momentul în care datele ajung utilizabile într-un catalog, un raport de prețuri sau o bază de date internă.
Articolul este util dacă vrei să înțelegi ce se întâmplă "sub capotă" înainte de a comanda un proiect de crawling sau web scraping, sau dacă evaluezi intern dacă un astfel de proces este fezabil pentru sursele de date de care ai nevoie.
Ce este, de fapt, un bot de crawling
Un bot de crawling este un program (script) care accesează pagini web în mod automat, în locul unui utilizator uman care ar da click manual pe fiecare link. Termenul crawling descrie procesul de parcurgere sistematică a paginilor (de la o pagină la alta, urmărind linkuri sau o listă de URL-uri), iar scraping descrie partea de extragere efectivă a datelor din conținutul acelor pagini. În practică, cei doi termeni sunt aproape mereu folosiți împreună, pentru că un script rar face doar una dintre cele două operații.
Un al treilea termen important este parsing (parsare) — procesul prin care scriptul "citește" codul HTML al unei pagini și identifică exact unde se află informația căutată (titlu de produs, preț, cod, descriere), pe baza structurii paginii (tag-uri HTML, clase CSS, atribute).
Pasul 1: scriptul trimite o cerere către pagina țintă
Totul pornește de la o listă de URL-uri (adrese de pagini) pe care scriptul trebuie să le viziteze. Pentru fiecare URL din listă, scriptul trimite o cerere HTTP către server — practic aceeași cerere pe care o trimite și browserul tău atunci când introduci o adresă și apeși Enter.
Serverul site-ului țintă primește cererea și răspunde, de regulă, cu codul HTML al paginii. Acest schimb — cerere trimisă, răspuns primit — este pasul de bază, repetat pentru fiecare pagină din listă. Un script bine construit trimite aceste cereri la intervale controlate, nu toate deodată, tocmai pentru a nu suprasolicita serverul țintă.
Pasul 2: descărcarea și citirea răspunsului serverului
Odată primit răspunsul, scriptul verifică mai întâi câteva lucruri de bază: dacă pagina există cu adevărat (cod de răspuns 200) sau dacă a returnat o eroare (pagină ștearsă, redirect, blocaj temporar). Dacă răspunsul este valid, scriptul salvează temporar conținutul HTML al paginii, pentru a-l putea analiza în pasul următor.
În această etapă, scriptul nu "înțelege" încă nimic din conținut — are doar textul brut al paginii, exact așa cum arată codul sursă. Interpretarea reală a informației se întâmplă la pasul de parsare.
Pasul 3: parsarea HTML-ului și extragerea datelor
Aici se întâmplă partea centrală a procesului. Scriptul folosește reguli precise (numite selectori) pentru a găsi, în codul HTML, exact locul unde se află fiecare informație de interes: titlul produsului poate fi într-un tag <h1> cu o anumită clasă CSS, prețul într-un <span> cu altă clasă, codul de produs într-un atribut ascuns.
Acești selectori sunt scriși în funcție de structura specifică a site-ului țintă — motiv pentru care un script de crawling este, de regulă, personalizat pentru fiecare sursă de date, nu un instrument universal care funcționează identic pe orice site. Dacă structura paginii se schimbă (de exemplu, site-ul țintă își modifică designul), selectorii trebuie ajustați, altfel scriptul nu mai extrage datele corect.
Pasul 4: curățarea și structurarea datelor extrase
Datele "brute" extrase din HTML rareori sunt gata de utilizat direct. Un preț poate apărea ca text de tipul "1.299,00 lei" în loc de o valoare numerică, un cod de produs poate avea spații sau caractere suplimentare, o descriere poate conține tag-uri HTML reziduale. În acest pas, scriptul normalizează aceste valori: transformă textul în format numeric unde e cazul, elimină spațiile și caracterele inutile, uniformizează formatul datelor (de exemplu, aceeași monedă și același format de dată pentru toate înregistrările).
Tot aici se pot include validări simple: dacă un preț extras este 0 sau lipsește un câmp obligatoriu, înregistrarea poate fi marcată pentru verificare manuală, în loc să fie salvată automat ca fiind corectă.
Pasul 5: salvarea datelor într-un format utilizabil
După curățare, datele sunt salvate în formatul stabilit pentru proiect: un fișier Excel/CSV, o bază de date relațională sau un feed XML/JSON, în funcție de cum urmează să fie folosite (import direct în magazin online, raport de monitorizare prețuri, integrare într-un alt sistem). Alegerea formatului de livrare se face de obicei la începutul proiectului, în funcție de sistemul în care vor ajunge datele.
Pasul 6: repetarea procesului și urmărirea linkurilor noi
Un crawler rareori se oprește după o singură pagină. De cele mai multe ori, scriptul identifică și link-uri noi în pagina curentă (de exemplu, produse dintr-o categorie paginată) și le adaugă la lista de pagini de vizitat. Procesul se repetă până când toate paginile relevante au fost parcurse.
Pentru proiecte continue (nu doar o extragere unică), scriptul rulează programat, la o frecvență stabilită — zilnic, la câteva ore, sau săptămânal — în funcție de cât de des se schimbă datele la sursă și de cât de critică este actualitatea lor pentru business.
Ce poate opri sau îngreuna un bot de crawling
Nu orice site poate fi accesat automat fără restricții, iar un proiect de crawling serios ține cont de acest lucru încă din faza de planificare.
- Fișierul robots.txt — majoritatea site-urilor publică un fișier
robots.txtcare indică ce părți ale site-ului pot fi accesate de roboți automați și care sunt excluse. Un crawler responsabil verifică și respectă aceste indicații. - Limite de rată (rate limiting) — dacă scriptul trimite prea multe cereri într-un timp scurt, serverul țintă poate bloca temporar accesul. Soluția corectă este introducerea unor pauze controlate între cereri, nu ocolirea blocajului.
- Schimbări de structură — un redesign al site-ului țintă poate "rupe" selectorii existenți, iar scriptul trebuie actualizat pentru a continua să extragă date corect.
- Conținut generat dinamic (JavaScript) — unele pagini încarcă datele ulterior, prin JavaScript, nu direct în HTML-ul inițial; un script de crawling trebuie construit diferit pentru astfel de cazuri.
Recomandarea generală, indiferent de sursă, este să verifici întotdeauna termenii de utilizare și fișierul robots.txt al site-ului țintă înainte de a porni un proiect de extragere, iar pentru situații neclare din punct de vedere legal, să consulți un specialist. Aceste aspecte sunt detaliate pe larg în ghidul nostru despre crawling legal, robots.txt și GDPR.
Script propriu, unealtă gata făcută sau serviciu extern
Odată ce înțelegi pașii de mai sus, apare firesc întrebarea: cine construiește și întreține acest script?
| Variantă | Când are sens | Ce presupune |
|---|---|---|
| Unealtă gata făcută (no-code) | Extragere simplă, o singură sursă, volum mic | Configurare rapidă, dar flexibilitate limitată la site-uri complexe |
| Script propriu, echipă internă | Ai deja developeri disponibili și proiecte recurente | Control total, dar necesită timp de dezvoltare și mentenanță continuă |
| Serviciu extern dedicat | Surse multiple, structuri complexe, actualizare periodică fără efort intern | Script personalizat pe sursa țintă, livrare în formatul cerut, mentenanță inclusă |
Diferența principală față de o unealtă generică este că un script personalizat, construit pentru o sursă anume, se adaptează exact la structura acelei pagini și poate fi actualizat rapid dacă site-ul țintă își schimbă designul — lucru pe care o soluție universală nu îl poate garanta.
Checklist practic înainte de a porni un proiect de crawling
- Ai definit clar ce date vrei extrase (câmpuri exacte: titlu, preț, cod, stoc, imagine)?
- Ai verificat robots.txt și termenii site-ului țintă?
- Ai stabilit frecvența de colectare (o singură dată, zilnic, săptămânal)?
- Ai stabilit formatul de livrare (Excel, bază de date, feed XML/CSV)?
- Ai un plan pentru cazul în care site-ul țintă își schimbă structura?
Întrebări frecvente despre funcționarea unui bot de crawling
Un bot de crawling este același lucru cu un bot de Google?
Mecanismul de bază este similar (cerere HTTP, citire HTML, urmărire de linkuri), dar scopul diferă. Botul de Google indexează paginile pentru motorul de căutare, în timp ce un bot de crawling pentru business extrage date specifice (prețuri, produse, stocuri) pentru un scop definit, de obicei intern.
Are nevoie un script de crawling de acces special la site-ul țintă?
Nu, în mod normal accesează aceleași pagini publice pe care le-ar vedea și un vizitator obișnuit, fără autentificare. Dacă datele necesare sunt disponibile doar în spatele unui cont, situația se tratează diferit și necesită verificare explicită a permisiunilor.
Cât timp durează extragerea datelor de pe un site?
Depinde de numărul de pagini și de pauzele impuse între cereri (pentru a nu suprasolicita serverul țintă). Un catalog cu câteva mii de produse poate dura de la câteva minute la câteva ore, în funcție de aceste setări.
Ce se întâmplă dacă site-ul țintă își schimbă designul?
Selectorii folosiți de script pentru a găsi datele nu mai corespund structurii noi, iar extragerea se oprește sau returnează date incomplete. Scriptul trebuie ajustat pentru noua structură — de aceea proiectele de crawling continue includ, de regulă, mentenanță periodică.
Poate un script de crawling să extragă orice informație de pe orice site?
Nu. Disponibilitatea depinde de permisiunile site-ului țintă (robots.txt, termeni de utilizare) și de modul în care este construită pagina (conținut static vs. generat prin JavaScript). Un proiect serios verifică aceste limitări înainte de a estima ce se poate extrage.
Concluzie
Un bot de crawling nu este altceva decât un script care repetă, la scară, o secvență simplă: cerere către o pagină, citire a răspunsului, extragere de date după reguli precise, curățare și salvare într-un format utilizabil. Complexitatea reală apare în detalii — structura fiecărui site, limitele legale și tehnice, mentenanța pe termen lung — nu în conceptul de bază.
Dacă vrei să automatizezi colectarea de date pentru magazinul tău sau pentru cercetarea de piață, contactează-ne pentru o ofertă personalizată, adaptată exact la sursele de care ai nevoie. Poți vedea și detaliile complete ale serviciului nostru de preluare date online prin crawling.
Imagine generată cu AI, folosită în scop ilustrativ.
Scrie un comentariu