 Engleza
 Romana
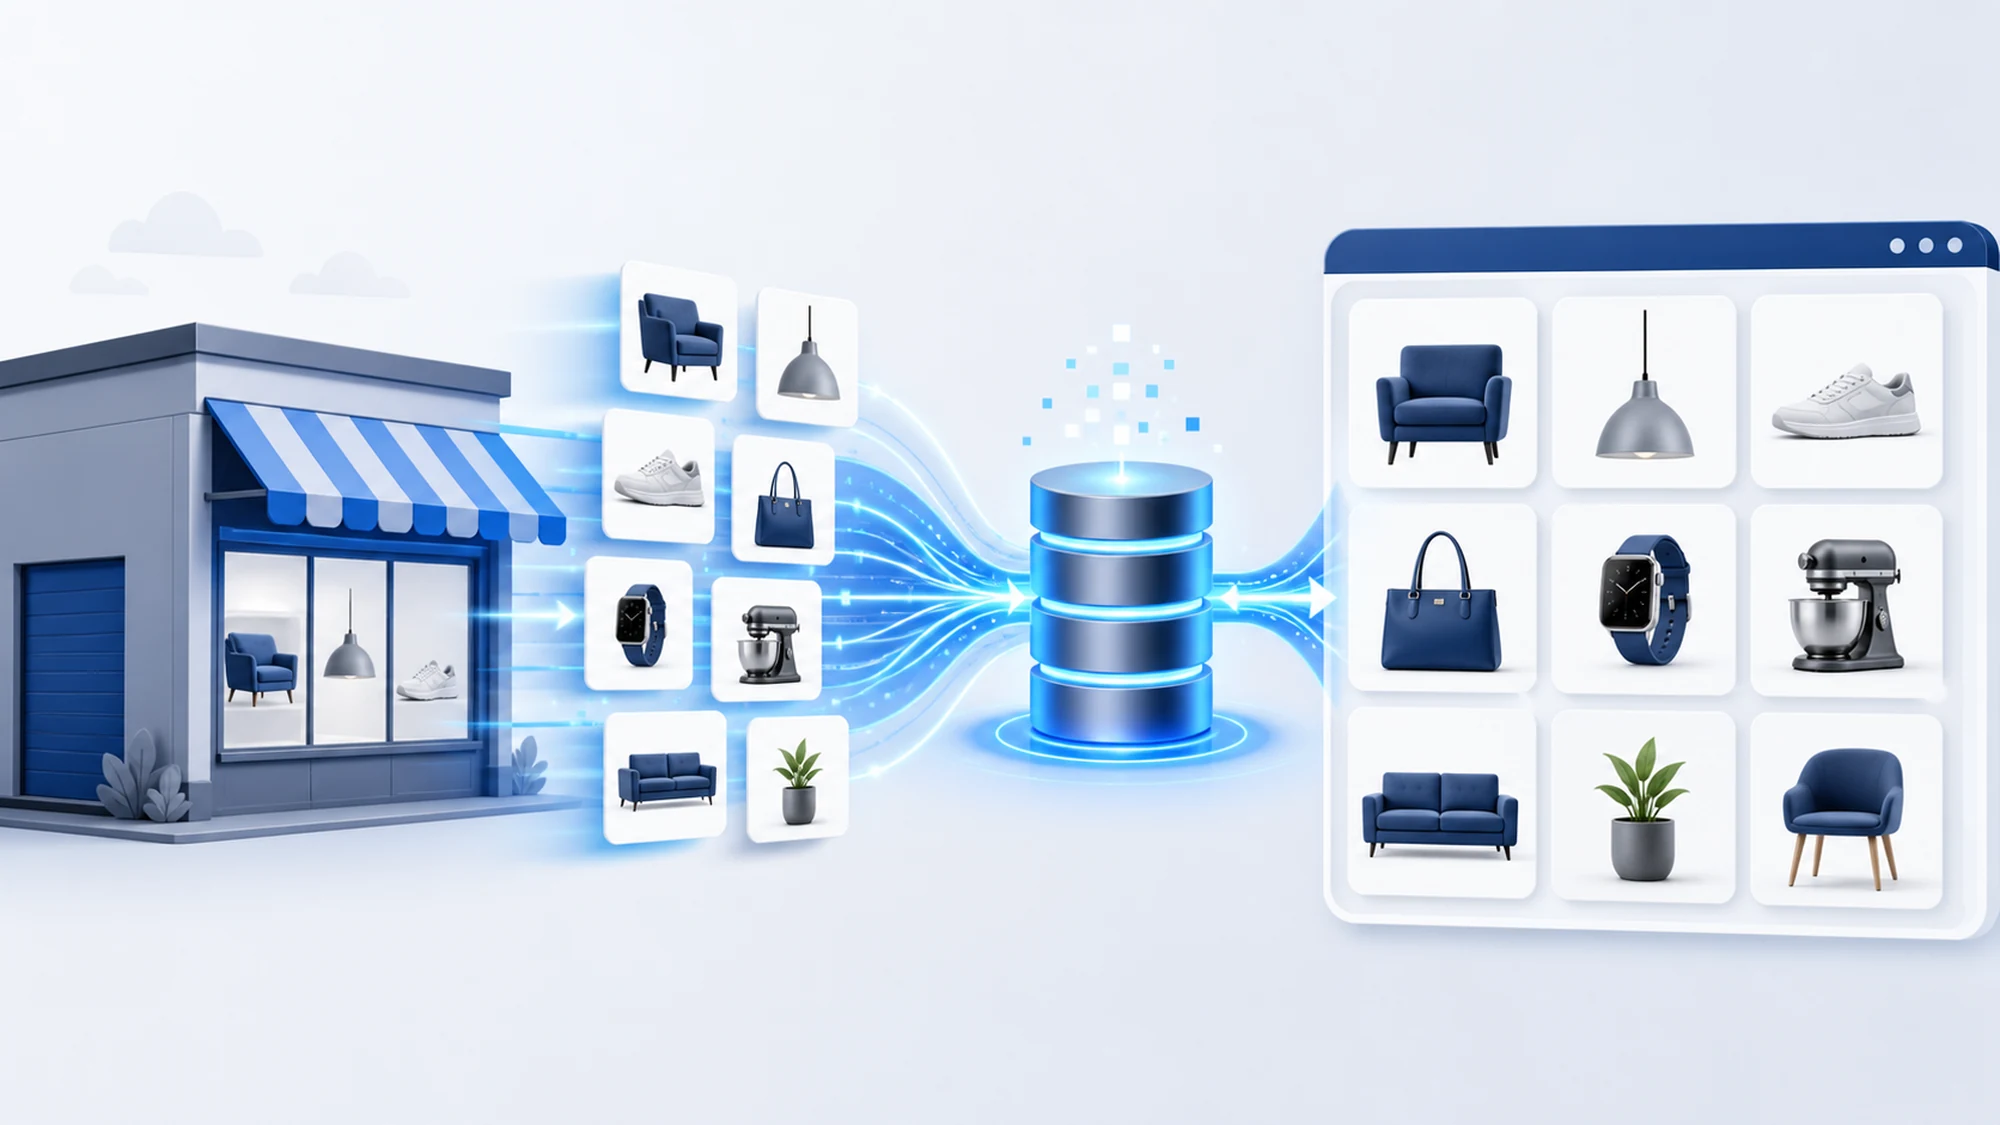
Cand un magazin online lucreaza cu zeci sau sute de furnizori, introducerea manuala a produselor devine punctul care franeaza tot lansarea de produse noi. Crawling-ul rezolva exact aceasta problema: preia automat titlul, codul, producatorul, descrierea, pretul si imaginile direct din sursele furnizorilor si le livreaza gata structurate pentru catalog.
Diferenta fata de introducerea manuala nu e doar de viteza. O echipa care introduce produse manual face greseli de tastare, sare campuri si ramane mereu in urma cu actualizarile de pret sau stoc. Un script de crawling ruleaza dupa acelasi tipar de fiecare data, la o frecventa stabilita, si livreaza date consistente, indiferent daca vorbim de 200 sau 20.000 de produse.
In articolul de fata explicam pasii concreti prin care datele ajung de la site-ul furnizorului in catalogul propriu, ce probleme apar frecvent in practica si cum se calculeaza, orientativ, efortul unui astfel de proiect.
Ce inseamna, concret, populare automata a catalogului prin crawling
Popularea automata a catalogului prin crawling inseamna folosirea unui script (bot) care viziteaza periodic paginile de produs ale unui furnizor, extrage campurile relevante si le transforma intr-un format pe care magazinul online il poate importa direct. Crawling-ul este procesul prin care botul parcurge paginile web ale sursei, iar parsing-ul este pasul in care datele brute (HTML) sunt transformate in campuri structurate: titlu, cod produs, categorie, pret, stoc, atribute tehnice, imagini.
Rezultatul nu e o simpla lista de linkuri, ci un set de date gata de importat: un fisier Excel, o baza de date relationala sau un feed XML/CSV, in functie de cum functioneaza platforma de eCommerce a clientului.
Ce date poti extrage automat de la un furnizor
In functie de cat de detaliat este site-ul furnizorului, un proiect de crawling poate aduce:
- Titlu si descriere completa a produsului
- Cod producator (SKU) si cod intern al furnizorului
- Categorie si subcategorie, pentru mapare directa in structura proprie
- Pret de lista si, unde este afisat public, stoc disponibil
- Atribute tehnice (dimensiuni, culoare, compatibilitate, specificatii)
- Imagini de produs, in rezolutia disponibila pe sursa
Nu toate site-urile de furnizori afiseaza public toate aceste campuri. Unele au preturi vizibile doar dupa autentificare in cont de partener, iar in acest caz solutia tehnica trebuie adaptata (crawling autentificat) sau inlocuita cu o discutie directa cu furnizorul pentru un export de date.
Cum arata procesul, pas cu pas
Un proiect de automatizare a popularii catalogului urmeaza, de regula, aceeasi succesiune de etape:
- Analiza sursei — se verifica structura site-ului furnizorului, robots.txt si daca datele necesare sunt publice.
- Construirea scriptului dedicat — fiecare furnizor are propria structura HTML, deci scriptul de extragere se scrie specific pentru sursa respectiva.
- Mapare de campuri — campurile extrase (titlu, cod, pret) se aliniaza la structura catalogului propriu, inclusiv categoriile.
- Validare si curatare date — se elimina duplicate, caractere corupte si campuri goale inainte de import.
- Livrare in formatul cerut — Excel, baza de date sau feed, dupa cum importa platforma de eCommerce.
- Programare periodica — scriptul ruleaza automat la intervalul stabilit, pentru actualizari ulterioare de pret si stoc.
Crawling vs API oficial de furnizor: cand alegi ce
Daca furnizorul ofera un API oficial sau un feed dedicat de date, aceasta este intotdeauna prima optiune de luat in calcul — e mai stabila si nu depinde de structura HTML a paginii. Crawling-ul devine solutia potrivita cand furnizorul nu ofera niciun API, nu are un feed de date structurat sau accesul la API presupune costuri/integrari pe care furnizorul nu le pune la dispozitie tuturor partenerilor.
| Criteriu | API oficial furnizor | Crawling |
|---|---|---|
| Disponibilitate | Doar daca furnizorul il ofera | Posibil pentru orice site public |
| Stabilitate in timp | Ridicata, cu documentatie oficiala | Depinde de structura paginii sursei |
| Viteza de implementare | Rapida, daca exista documentatie | Necesita script dedicat per sursa |
| Camp de date disponibil | Limitat la ce expune API-ul | Tot ce e afisat public pe pagina |
In practica, multe magazine folosesc o combinatie: API acolo unde exista, crawling pentru restul furnizorilor. Aceasta decizie se ia per sursa de date, nu la nivel de proiect intreg.
Riscuri frecvente si cum le previi
Automatizarea aduce viteza, dar are si puncte sensibile care trebuie gestionate din start:
- Schimbarea structurii site-ului furnizorului — orice redesign al paginii poate opri extragerea corecta. Mitigare: monitorizare periodica a scriptului si alertare automata cand rezultatele scad brusc.
- Date incomplete sau inconsistente — unele produse nu au toate campurile completate pe sursa. Mitigare: reguli de validare care marcheaza produsele incomplete pentru verificare manuala, in loc sa le importe direct.
- Permisiuni neclare privind extragerea — nu toate site-urile permit crawling. Mitigare: verifica intotdeauna robots.txt si Termenii si Conditiile sursei inainte de a porni colectarea; pentru situatii neclare, cere confirmarea scrisa a furnizorului sau consulta un specialist juridic.
- Duplicate intre furnizori — acelasi produs poate aparea la mai multi furnizori cu coduri diferite. Mitigare: reguli de potrivire dupa cod producator sau EAN, nu doar dupa titlu.
Cat de des trebuie sincronizat catalogul cu datele furnizorului
Frecventa depinde de tipul de data si de cat de volatil este pretul in domeniul respectiv. Pentru cataloage cu preturi stabile, o sincronizare saptamanala poate fi suficienta. Pentru categorii cu preturi care se schimba des (electronice, piese auto cu stoc limitat), o actualizare zilnica sau chiar de mai multe ori pe zi reduce riscul de a vinde la un pret vechi sau un produs epuizat la furnizor. Stocul, cand este public, merita cea mai frecventa verificare dintre toate campurile.
Plan practic de implementare pentru un proiect de acest tip
Un plan realist pentru a trece de la introducere manuala la populare automata arata astfel:
- Saptamana 1 — inventar de furnizori, verificare robots.txt/permisiuni si stabilirea campurilor obligatorii pentru catalog.
- Saptamana 2-3 — dezvoltarea scriptului dedicat pentru sursele prioritare si prima livrare de date de test.
- Saptamana 4 — mapare finala de categorii, validare date si import in catalogul de productie.
- Continuu — programare automata a sincronizarilor si monitorizare periodica a scriptului fata de schimbari pe sursa.
Cat costa automatizarea popularii catalogului
Costul unui astfel de proiect depinde de trei factori principali: complexitatea datelor cerute (cate campuri, cate atribute tehnice), volumul de produse si numarul de furnizori diferiti (fiecare sursa inseamna, de regula, un script propriu, pentru ca fiecare site are alta structura). Prima colectare de la o sursa noua este mereu mai consistenta ca efort decat sincronizarile ulterioare, care ruleaza pe scriptul deja construit. Pentru o estimare concreta pe numarul tau de furnizori, cea mai directa cale este o discutie punctuala despre proiect.
Intrebari frecvente
Se poate face automatizarea popularii catalogului pentru orice furnizor?
Nu automat pentru toti. Depinde daca furnizorul afiseaza public datele necesare si daca site-ul permite crawling conform robots.txt si Termenilor si Conditiilor. Pentru furnizorii cu date protejate sau accesibile doar prin cont de partener, solutia potrivita poate fi un export de date negociat direct cu furnizorul.
Ce se intampla daca furnizorul isi schimba site-ul?
Scriptul de extragere este construit pe structura curenta a paginii, deci o schimbare majora de design poate necesita ajustarea scriptului. Monitorizarea periodica a rezultatelor permite detectarea rapida a acestor situatii, inainte ca datele importate sa devina incomplete.
Datele extrase inlocuiesc complet munca manuala?
Reduc semnificativ volumul de introducere manuala, dar o verificare punctuala ramane utila, mai ales pentru produsele marcate ca incomplete dupa validare sau pentru categorii noi care nu au fost inca mapate.
Cat de repede se vede rezultatul dupa implementare?
Prima livrare de date poate fi gata dupa primele saptamani de dezvoltare a scriptului (vezi planul de implementare de mai sus), insa valoarea reala apare dupa ce sincronizarile automate ruleaza constant si catalogul ramane actualizat fara interventie manuala repetata.
Ce format de livrare a datelor se potriveste catalogului meu?
Depinde de platforma de eCommerce folosita: unele importa direct fisiere Excel/CSV, altele au nevoie de o baza de date relationala sau de un feed XML structurat. Formatul se stabileste in etapa de analiza a proiectului, inainte de dezvoltarea scriptului.
Concluzie
Automatizarea popularii catalogului cu date de la furnizori, prin crawling, inlocuieste orele de introducere manuala cu un flux repetabil: extragere, validare, import, sincronizare periodica. Cel mai important pas ramane verificarea corecta a permisiunilor fiecarei surse inainte de a porni colectarea, urmata de un script construit specific pentru structura fiecarui furnizor.
Vrei sa automatizezi colectarea datelor de la furnizorii tai si sa scapi de introducerea manuala in catalog? Discutam proiectul tau sau vezi serviciul complet: Servicii preluare date online (crawling).


Scrie un comentariu