 EN
 RO
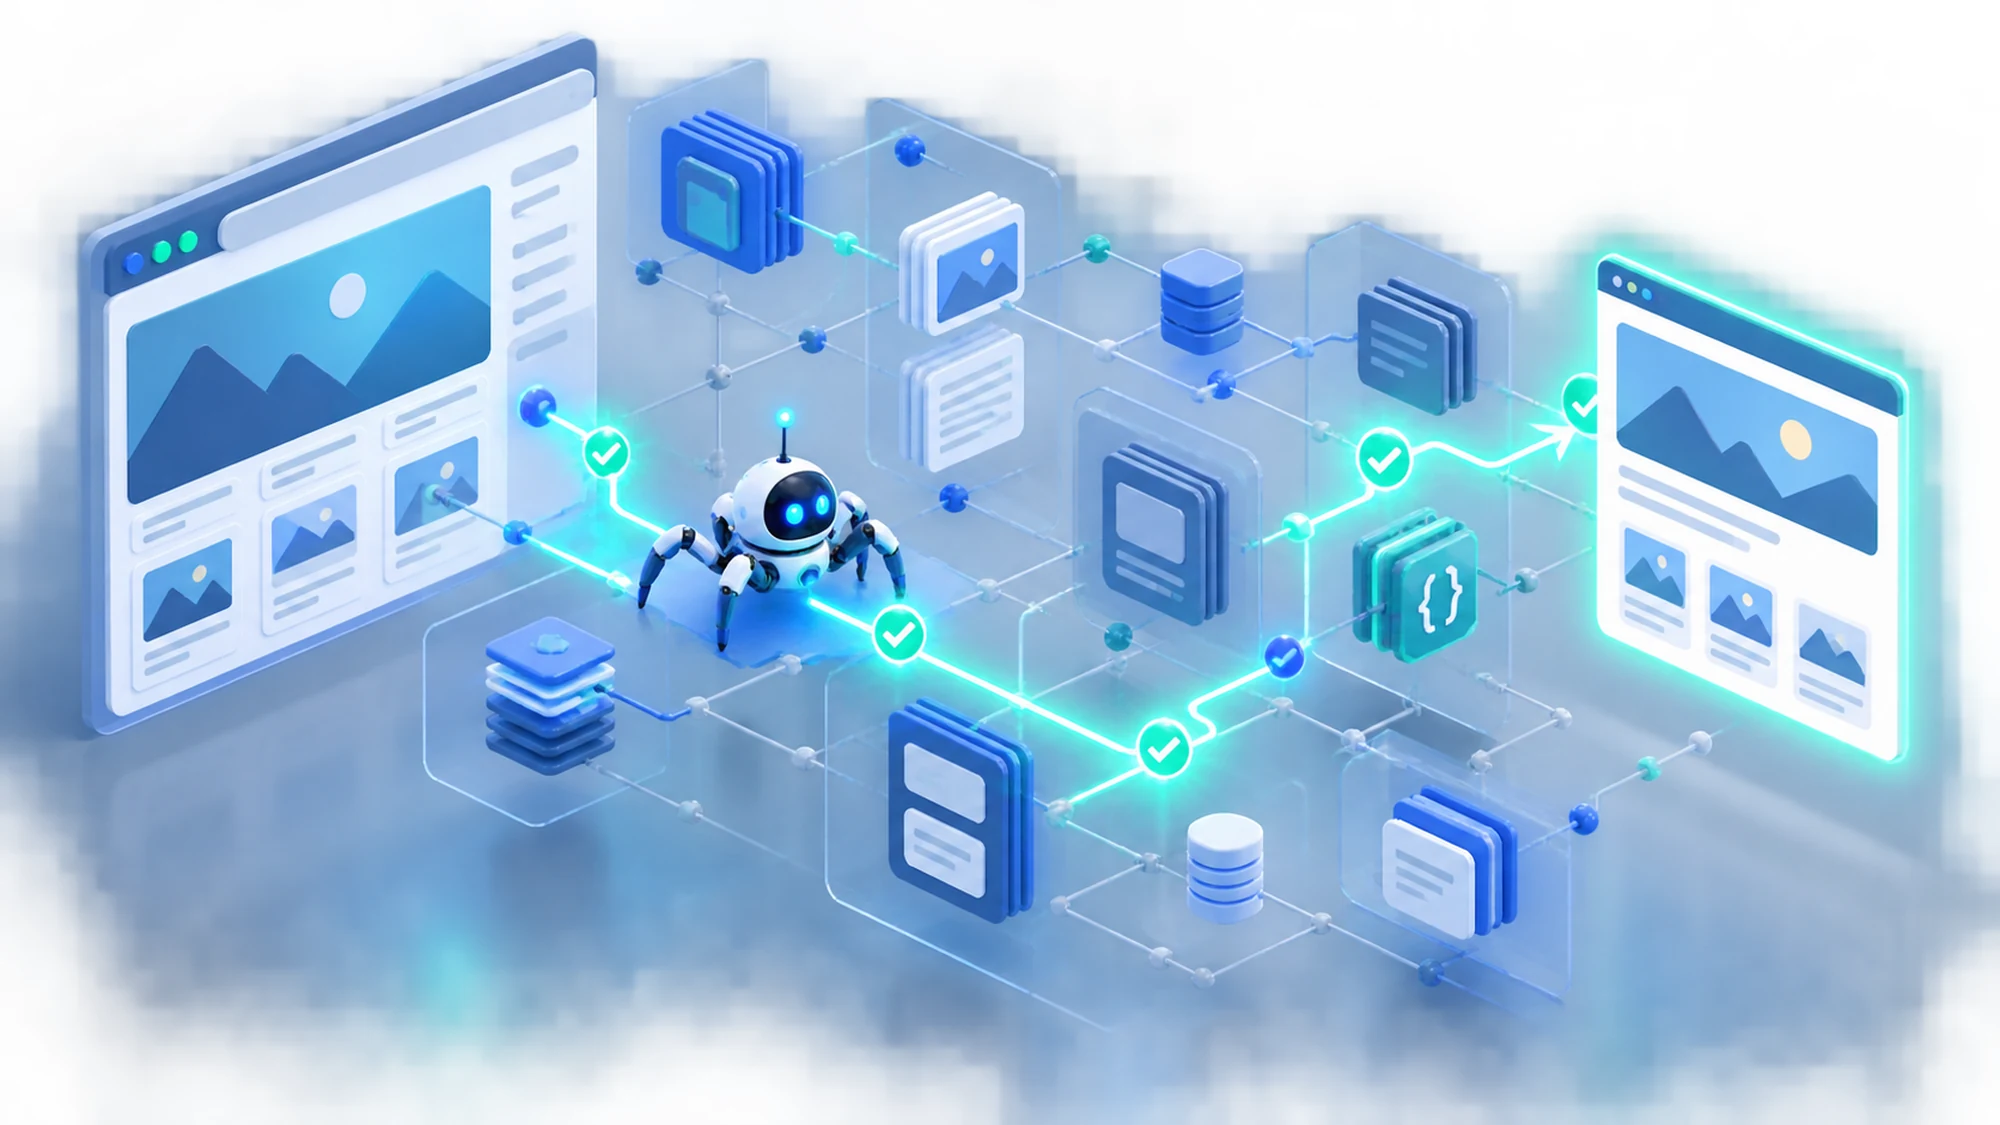
Un site construit in React sau Vue poate arata perfect in browser si totusi sa fie aproape invizibil pentru Google, daca continutul principal exista doar dupa ce JavaScript-ul se executa in browser-ul utilizatorului. Googlebot poate randa JavaScript, dar face acest lucru intr-o etapa separata, cu resurse limitate si intarzieri, iar alti crawleri (Bing, roboti de retele sociale, unele instrumente AI) fie nu randeaza deloc JavaScript, fie o fac partial.
Solutia practica nu este sa renunti la React sau Vue, ci sa alegi corect strategia de randare (server-side, static sau hibrida), sa expui continutul esential inainte de hidratare si sa verifici constant, prin instrumente concrete, ce vede de fapt Google din pagina ta.
Acest ghid explica, pas cu pas, ce inseamna randarea client-side din perspectiva unui crawler, ce probleme tehnice apar cel mai des si cum le previi sau le rezolvi, cu exemple aplicabile pentru proiecte reale.
Ce inseamna randarea client-side pentru un crawler
Intr-un site clasic, server-side rendered (SSR) sau static, serverul trimite catre browser un fisier HTML care contine deja titlul, textul si linkurile paginii. Intr-un Single Page Application (SPA) construit pur client-side, serverul trimite un HTML aproape gol, de obicei un singur <div id="root"></div>, iar continutul real este generat ulterior de JavaScript, direct in browser.
Pentru un utilizator uman, diferenta este invizibila, pentru ca browser-ul executa scriptul imediat. Pentru un crawler insa, executia JavaScript este o etapa separata si costisitoare: Google descarca intai HTML-ul brut, il pune in coada pentru randare, apoi, cand are resurse disponibile, executa scripturile si vede continutul final. Aceasta a doua etapa poate dura de la cateva minute la cateva zile, in functie de bugetul de crawlare alocat site-ului.
Alti crawleri sau agenti (unele instrumente de generare a preview-urilor de social media, crawleri mai vechi, unele instrumente AI de indexare a continutului) pot sa nu execute deloc JavaScript, caz in care vad exact HTML-ul initial, gol sau incomplet.
Cum indexeaza Google efectiv un site JavaScript (randare in doua valuri)
Google descrie explicit procesul in documentatia oficiala pentru Search Central: crawling-ul si indexarea unui site JavaScript se produc in doua valuri distincte.
- Primul val (crawling initial): Googlebot descarca HTML-ul brut si extrage din el linkurile si continutul static disponibil imediat. Daca aplicatia depinde total de JavaScript, in acest pas Google vede foarte putin.
- Coada de randare: URL-ul este pus intr-o coada de asteptare pana cand Google aloca resursele necesare pentru a executa JavaScript-ul, folosind o versiune Chromium actualizata (Web Rendering Service).
- Al doilea val (randare si indexare finala): dupa executia scriptului, Google reevalueaza continutul, extrage titlul, textul si linkurile aparute dupa hidratare si le integreaza in index.
Intarzierea dintre cele doua valuri este motivul principal pentru care paginile noi dintr-un SPA pur client-side apar mai greu in index, iar linkurile interne generate doar dupa randare pot fi descoperite si urmate cu intarziere semnificativa fata de un site SSR.
Cele mai frecvente probleme de crawlare si indexare la React si Vue
Majoritatea problemelor de SEO tehnic la aplicatiile JavaScript se incadreaza in cateva tipare recurente, indiferent daca framework-ul folosit este React, Vue, Angular sau altul similar.
| Problema | Cauza tehnica | Efect in Search Console |
|---|---|---|
| Continut absent din index | Textul principal exista doar dupa hidratare, iar randarea Google esueaza sau are timeout | "Descoperit - in prezent neindexat" sau "Randat, continut alternativ blocat" |
| Linkuri interne nedescoperite | Navigatia foloseste handlere JavaScript (onClick) in loc de tag-uri <a href> reale | Pagini profunde neindexate, sitemap ca unica sursa de descoperire |
| Meta tag-uri identice pe toate paginile | Title si meta description sunt setate doar prin JavaScript, dupa randare, la timpi diferiti pe fiecare pagina | Titluri si descrieri incorecte sau generice in rezultatele de cautare |
| Continut blocat pentru randare | Fisiere JS/CSS necesare randarii sunt blocate prin robots.txt | Avertisment explicit "Pagina cu probleme de incarcare a resurselor" in Search Console |
| Continut duplicat intre rute | Routing client-side (History API) fara URL-uri canonice distincte per stare a paginii | URL-uri canonicalizate gresit sau consolidate incorect de Google |
Cand alegi SSR, SSG sau hidratare partiala pentru un proiect nou
Alegerea strategiei de randare este decizia tehnica cu cel mai mare impact asupra SEO intr-un proiect React sau Vue. Nu exista o solutie universal corecta, ci un criteriu simplu: cat de des se schimba continutul si cat de critic este sa fie indexat rapid.
- Static Site Generation (SSG): potrivit pentru pagini de continut relativ stabil (pagini de servicii, articole de blog, pagini de brand). HTML-ul complet este generat la build time, deci Google primeste direct continutul final, fara sa astepte randarea. Framework-uri precum Next.js sau Nuxt ofera SSG nativ pentru React, respectiv Vue.
- Server-Side Rendering (SSR): potrivit pentru continut dinamic (pagini de produs cu stoc si pret variabil, rezultate de cautare interna, continut personalizat partial). Serverul genereaza HTML-ul complet la fiecare cerere, apoi JavaScript-ul preia controlul in browser (hidratare).
- Hidratare partiala / islands architecture: potrivita pentru site-uri mari, cu zone mixte de continut static si interactiuni complexe, unde doar componentele care au nevoie de interactivitate sunt hidratate, restul ramane HTML static.
- Client-Side Rendering (CSR) pur: acceptabil pentru aplicatii care nu au nevoie de vizibilitate in motoarele de cautare (dashboard-uri interne, panouri de administrare, aplicatii dupa autentificare). Nepotrivit pentru pagini publice care trebuie sa apara in Google.
Pentru un site public nou construit in React sau Vue, alegerea implicita ar trebui sa fie SSR sau SSG, nu CSR pur, tocmai pentru a evita dependenta de coada de randare a Google descrisa mai sus.
Migrare de la CSR pur la SSR/SSG: pasi practici fara sa rescrii aplicatia de la zero
Pentru un proiect existent, construit deja ca SPA client-side, migrarea completa la SSR poate fi costisitoare. Exista insa un set de pasi intermediari care reduc semnificativ riscul de indexare incompleta, fara sa presupuna o rescriere totala.
- Identifica paginile publice critice pentru SEO (pagini de servicii, produse, articole) si separa-le de zonele private/dupa autentificare, care nu au nevoie de randare server-side.
- Adauga SSR sau SSG doar pentru paginile identificate, folosind un framework care suporta randare hibrida (Next.js pentru React, Nuxt pentru Vue), pastrand restul aplicatiei neschimbat.
- Inlocuieste navigatia bazata exclusiv pe JavaScript cu linkuri reale (
<a href="/pagina">), astfel incat crawlerul sa descopere rutele fara sa astepte executia scriptului. - Muta setarea de title si meta description din componente randate tarziu in partea de randare initiala (server-side sau la build time), nu doar in
useEffectsau echivalentul din Vue. - Genereaza un sitemap XML actualizat automat la fiecare publicare de continut nou, ca sursa de descoperire suplimentara fata de linkurile interne.
- Testeaza fiecare pagina critica cu instrumentul URL Inspection din Search Console, comparand HTML-ul randat de Google cu ce vede un utilizator in browser.
Riscuri frecvente si cum le previi
Chiar si dupa ce alegi SSR sau SSG, pot ramane capcane tehnice care anuleaza partial beneficiul randarii server-side. Cele mai intalnite, in proiecte reale, sunt urmatoarele.
- Continut cu hidratare incompleta ("flash gol"): HTML-ul initial contine continutul corect, dar componenta se re-randeaza gol pentru o fractiune de secunda la hidratare, iar in unele configurari acest gol ajunge sa fie ceea ce retine randarea Google. Mitigare: verifica prin URL Inspection ca HTML-ul final randat contine textul, nu doar HTML-ul initial de pe server.
- Blocarea resurselor JS/CSS in robots.txt: o practica veche, mostenita din epoca in care fisierele JS erau blocate din motive de buget de crawlare. Astazi, blocarea acestor resurse impiedica Google sa randeze corect pagina. Mitigare: permite explicit accesul la fisierele JS si CSS necesare randarii.
- Canonical setat doar client-side: daca tag-ul canonical este injectat de JavaScript dupa randare, exista riscul ca Google sa foloseasca temporar URL-ul brut, inainte de randare, pentru decizii de canonicalizare. Mitigare: seteaza canonical in HTML-ul livrat de server, nu doar prin JavaScript.
- Timp de raspuns mare la randare (TTFB si Time to Interactive): SSR mutat gresit (fara caching corespunzator) poate incetini serverul, afectand Core Web Vitals si implicit experienta de crawlare. Mitigare: foloseste caching la nivel de pagina/rasa (edge caching, ISR in Next.js) pentru paginile publice care nu se schimba la fiecare request.
- Rute infinite generate dinamic (fatete, parametri): filtrele si parametrii de URL generati client-side pot crea variatii aproape infinite de URL-uri, consumand bugetul de crawlare. Mitigare: canonicalizeaza catre versiunea fara parametri si controleaza indexarea fatetelor prin robots meta, nu doar prin robots.txt.
Cum verifici efectiv ce vede Google din pagina ta
Nu este suficient sa presupui ca randarea functioneaza corect; verificarea trebuie facuta explicit, pentru fiecare tip de pagina critica, folosind instrumente concrete, nu doar inspectia vizuala din browser.
| Instrument | Ce verifica | Cand il folosesti |
|---|---|---|
| URL Inspection (Search Console) | HTML-ul randat de Googlebot, resursele blocate, statusul de indexare | Dupa fiecare lansare de pagina noua sau modificare majora de rutare |
| Raport "Pagini" (Search Console) | Cauzele de neindexare la nivel de site ("Descoperit - in prezent neindexat", "Randat, continut duplicat") | Lunar, ca monitorizare de rutina |
| View Source vs. Inspect Element | Diferenta dintre HTML-ul brut trimis de server si DOM-ul final dupa executia JavaScript | La depanarea rapida a unei pagini care nu apare in index |
| curl sau un HTTP client fara JavaScript | Ce primeste un crawler care nu executa deloc JavaScript | Test rapid, fara instrumente vizuale, pentru continut critic (title, H1, linkuri) |
O regula practica de decizie: daca textul principal, titlul H1 si linkurile interne critice ale unei pagini publice nu apar in raspunsul brut al serverului (fara executie JavaScript), pagina respectiva depinde integral de coada de randare a Google si trebuie tratata ca risc de indexare, indiferent cat de bine arata vizual in browser.
Plan practic de implementare (checklist)
- Identifica paginile publice care trebuie sa fie indexabile si separa-le de zonele private.
- Alege strategia de randare per tip de pagina: SSG pentru continut stabil, SSR pentru continut dinamic.
- Inlocuieste navigatia bazata pe JavaScript cu linkuri
<a href>reale. - Seteaza title, meta description si canonical in HTML-ul initial, nu doar client-side.
- Permite in robots.txt accesul la fisierele JS/CSS necesare randarii.
- Genereaza si trimite un sitemap XML actualizat automat la fiecare publicare.
- Verifica fiecare pagina critica prin URL Inspection dupa lansare.
- Monitorizeaza lunar raportul "Pagini" din Search Console pentru semnale de neindexare.
Intrebari frecvente despre SEO tehnic pe site-uri JavaScript
React sau Vue afecteaza automat SEO-ul unui site?
Nu automat, ci in functie de strategia de randare aleasa. Un site React sau Vue randat server-side (SSR) sau static (SSG) poate avea performante SEO identice cu un site HTML clasic. Problemele apar cand aplicatia este construita ca SPA pur client-side, fara nicio forma de randare pe server.
Google indexeaza JavaScript sau nu?
Da, Google poate executa JavaScript prin Web Rendering Service, dar acest lucru se intampla intr-o a doua etapa, separata de crawling-ul initial, si consuma resurse suplimentare de la Google. Randarea nu este instantanee si nu este garantata pentru fiecare pagina in acelasi ritm.
Este suficient sa adaug un sitemap XML pentru un SPA fara SSR?
Sitemap-ul ajuta la descoperirea URL-urilor, dar nu rezolva problema continutului care exista doar dupa executia JavaScript-ului. Fara SSR sau SSG, pagina poate fi descoperita prin sitemap si totusi sa ramana neindexata daca randarea esueaza sau intarzie.
Ce diferenta este intre SSR si prerendering static?
SSR genereaza HTML-ul la fiecare cerere, pe server, potrivit pentru continut care se schimba des. Prerendering-ul static (SSG) genereaza HTML-ul o singura data, la build time, potrivit pentru continut relativ stabil. Ambele rezolva aceeasi problema de baza: livreaza continutul complet crawlerului, fara sa depinda de randarea client-side.
Cum stiu daca site-ul meu actual are o problema reala de indexare cauzata de JavaScript?
Compara raspunsul brut al serverului (fara executie JavaScript, de exemplu prin curl) cu ce vezi in browser. Daca titlul, H1 si continutul principal lipsesc din raspunsul brut, iar raportul "Pagini" din Search Console arata pagini in stare "Descoperit - in prezent neindexat", problema este cel mai probabil legata de randarea client-side.
Concluzie
SEO tehnic pentru site-urile JavaScript nu inseamna sa renunti la React sau Vue, ci sa alegi constient strategia de randare potrivita fiecarui tip de pagina si sa verifici constant, cu instrumente concrete, ce vede efectiv Google, nu doar ce vede un utilizator in browser. Un site public construit exclusiv client-side ramane un risc de indexare, indiferent cat de bine arata vizual, iar SSR sau SSG raman cele mai sigure directii pentru paginile care trebuie sa apara in cautari.
Vrei sa verifici daca aplicatia ta React sau Vue are probleme reale de crawlare si indexare? Discutam un audit tehnic.
Scrie un comentariu