 EN
 RO
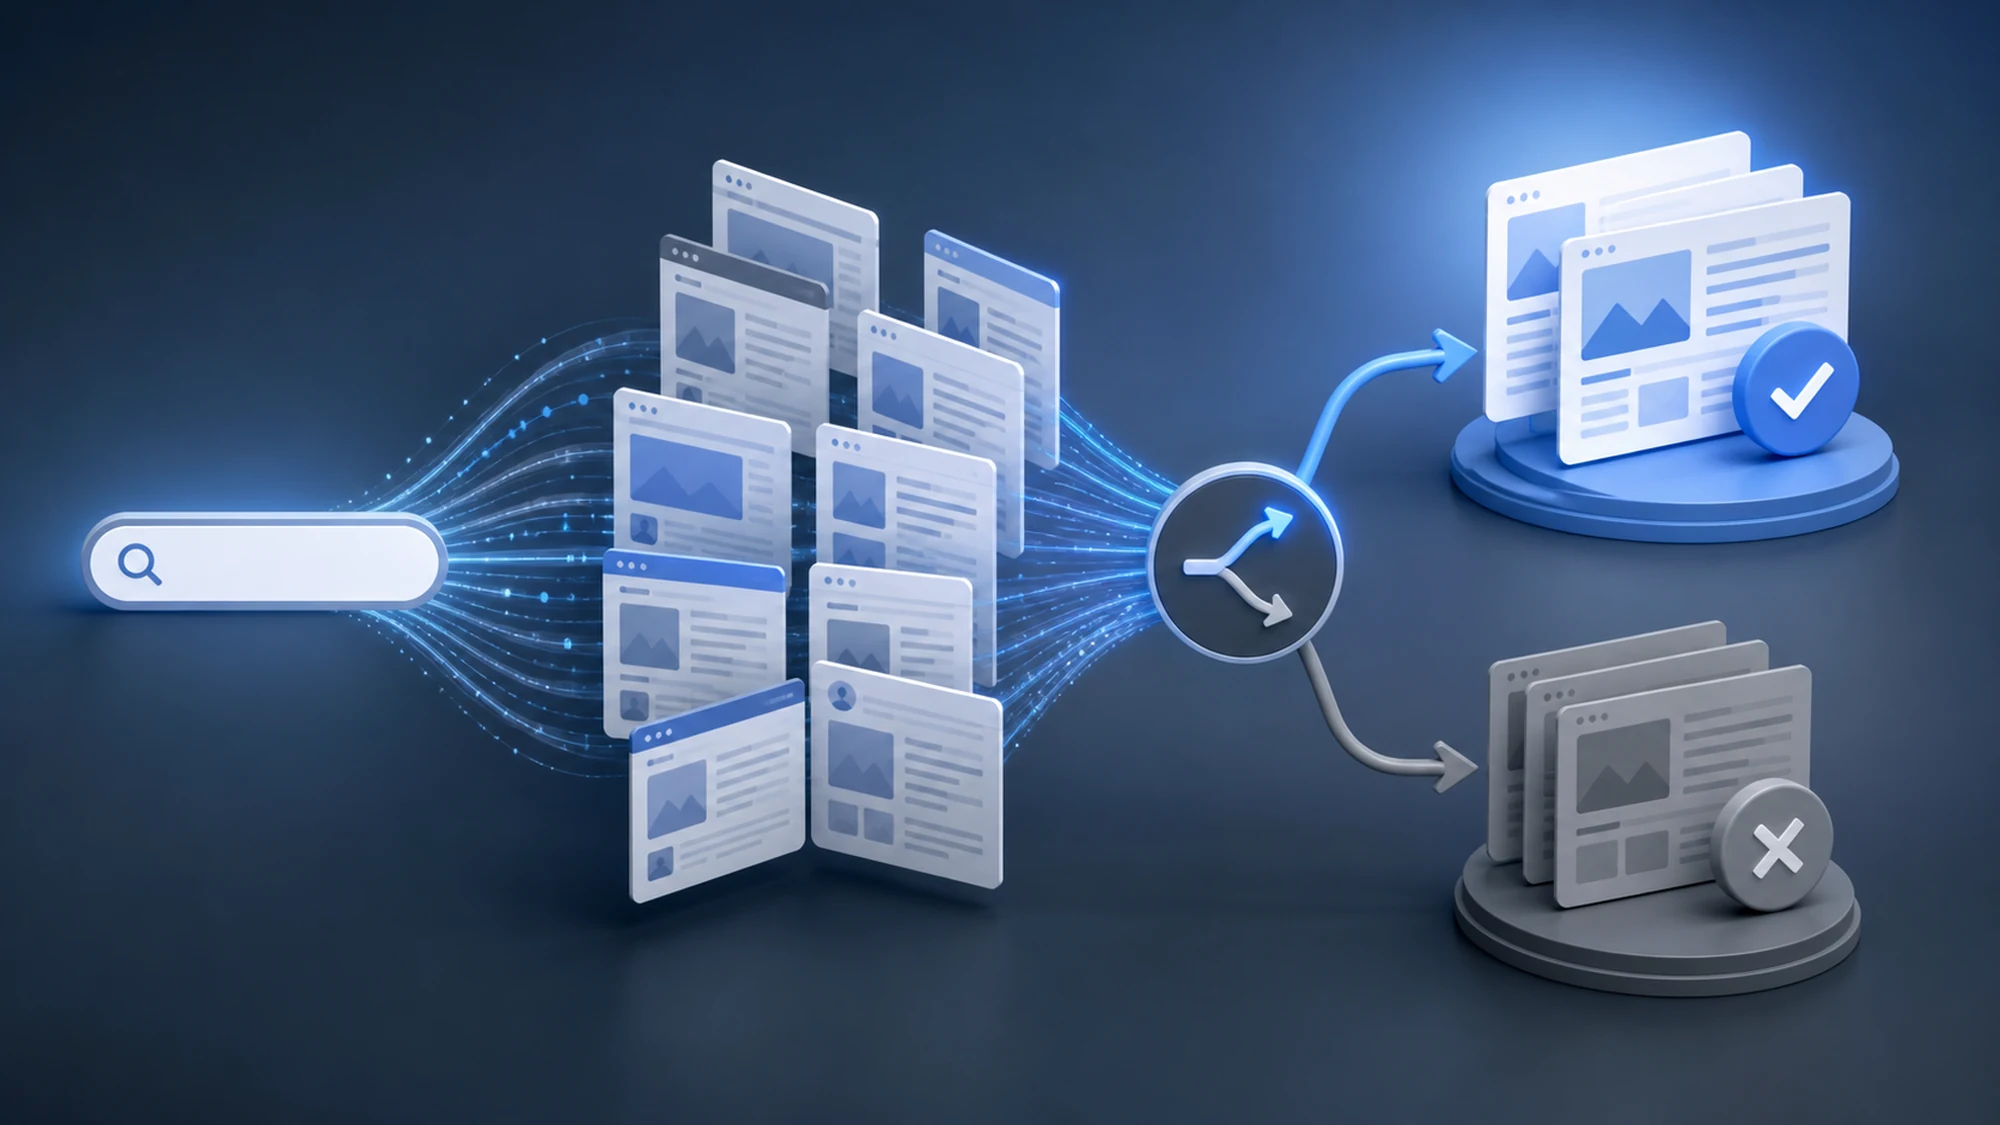
Paginile generate de motorul de cautare intern al unui site (site search) nu ar trebui, in marea majoritate a cazurilor, sa fie indexate de Google. Ele apar automat pentru fiecare termen introdus de utilizatori, produc mii de URL-uri aproape identice si consuma buget de crawlare fara sa aduca valoare in rezultatele organice.
Problema apare rar din neglijenta totala, ci mai des dintr-o decizie tehnica luata fara sa se gandeasca cineva la impactul SEO: un plugin de cautare instalat implicit, un URL cu parametru ?s= sau ?q= lasat crawlabil, sau o pagina de rezultate care nu are niciodata noindex setat explicit.
Acest ghid explica de ce paginile de cautare interna devin frecvent continut subtire in ochii Google, cand exista exceptii in care merita sa le indexezi, si ce combinatie de noindex, canonical si robots.txt previi ca ele sa afecteze crawl budget-ul si calitatea perceputa a domeniului.
De ce paginile de cautare interna sunt, de regula, continut subtire pentru Google
O pagina de rezultate de cautare interna afiseaza, de obicei, un titlu generic ("Rezultate pentru: [termen]"), o lista de linkuri catre alte pagini de pe site si putin sau deloc text original. Din perspectiva Google, aceasta structura seamana cu continut subtire (thin content): pagina nu raspunde singura la intentia de cautare, ci doar redirectioneaza vizual catre alte pagini care fac asta.
Riscul creste odata cu numarul de termeni cautati. Un site cu trafic mediu poate genera zeci de mii de combinatii unice de URL de cautare intr-un an — pentru fiecare greseala de scriere, sinonim sau variatie de termen introdusa de un utilizator. Daca aceste URL-uri sunt crawlabile si indexabile, Google le trateaza ca pagini reale de site, desi majoritatea nu au niciun vizitator organic si nicio valoare unica de continut.
Efectul secundar cel mai des intalnit este dilutia bugetului de crawlare: robotul Google petrece timp accesand mii de pagini de cautare interna, in loc sa recraweze mai des paginile de produs, categorie sau articol care chiar merita sa fie actualizate rapid in index.
Cum recunosti daca paginile tale de cautare interna sunt deja indexate
Inainte de a decide ce actiune aplici, verifica daca problema exista deja pe site-ul tau. Trei verificari rapide, in ordinea recomandata:
- Cautare cu operatorul
site:— in Google, cautasite:domeniultau.ro inurl:cautasau echivalentul parametrului folosit (inurl:search,inurl:?s=). Daca apar rezultate, paginile sunt indexate. - Google Search Console — raportul de acoperire (Pages) — filtreaza URL-urile indexate dupa tiparul de URL al cautarii interne si verifica numarul total de pagini afectate.
- robots.txt si sursa paginii — verifica daca URL-ul de cautare este blocat in
robots.txtsi daca in<head>exista deja<meta name="robots" content="noindex">pe acele pagini.
Daca gasesti pagini de cautare interna deja indexate cu trafic organic (situatie rara, dar posibila pentru termeni foarte specifici de produs), nu le elimina brusc — tratamentul corect pentru acel caz particular este descris in sectiunea de exceptii de mai jos.
Cand ai voie sa indexezi o pagina de cautare interna (exceptia, nu regula)
Regula generala este noindex, dar exista un scenariu in care indexarea are sens: cand o pagina de cautare interna raspunde, de fapt, unei intentii de cautare reale din Google, nu doar unei cautari facute de un utilizator deja aflat pe site. Cel mai comun exemplu este un magazin online cu o cautare de tip "cauta piesa dupa cod OEM" sau "cauta produs dupa marca+model", unde termenul cautat corespunde exact unei nevoi comerciale specifice.
In acest caz, pagina trebuie tratata ca o pagina de categorie propriu-zisa, nu ca o pagina de cautare generica: are nevoie de titlu unic, de un H1 descriptiv, de continut introductiv scris manual si de un URL curat, nu de un parametru de query brut. Practic, nu mai este o pagina de "rezultate cautare", ci o pagina de landing construita pe structura de cautare.
Pentru toate celelalte cazuri — cautare libera dupa cuvinte cheie generice introduse de utilizator — indexarea nu aduce beneficii si creste riscul de continut subtire in masa.
Noindex, canonical sau robots.txt: care e diferenta si cand alegi fiecare
Cele trei mecanisme rezolva probleme diferite si nu sunt interschimbabile. Alegerea gresita duce fie la pagini care raman indexate din greseala, fie la pierdere inutila de buget de crawlare.
| Mecanism | Ce face | Cand il folosesti |
|---|---|---|
noindex, follow | Scoate pagina din index, dar Google poate accesa in continuare linkurile din ea | Solutia principala pentru paginile de cautare interna: raman functionale pentru utilizatori, dispar din rezultatele Google |
| Canonical catre pagina de categorie | Spune Google ca varianta "oficiala" e alta pagina, dar nu garanteaza excluderea din crawlare | Util cand cautarea interna returneaza, de fapt, acelasi set de produse ca o categorie existenta — evita conflictul intre cele doua URL-uri |
| Disallow in robots.txt | Blocheaza accesul crawlerului la URL, dar nu garanteaza excluderea din index daca pagina are deja linkuri externe | Solutie suplimentara, nu unica — reduce crawl budget consumat, dar nu inlocuieste noindex pentru pagini deja indexate |
Combinatia recomandata pentru majoritatea site-urilor este noindex, follow direct pe pagina de cautare, plus un parametru URL exclus din Google Search Console (setarea de gestionare parametri, unde este inca disponibila) sau reguli clare in robots.txt pentru variantele de URL cu parametri de cautare.
Riscuri frecvente si cum le eviti
Cele mai dese greseli tehnice legate de paginile de cautare interna apar la implementare, nu la strategie:
- Noindex si Disallow aplicate simultan, gresit. Daca blochezi URL-ul in robots.txt, Google nu mai poate accesa pagina pentru a citi tag-ul
noindex— iar o pagina deja indexata inainte de blocare poate ramane in index nedefinit, fara continut vizibil in fragmentul din rezultate. Aplica intai noindex, elimina pagina din index, abia apoi ia in calcul blocarea prin robots.txt daca vrei sa economisesti crawl budget. - Rezultate de cautare fara pagina goala tratata corect. Cand cautarea nu returneaza niciun rezultat, pagina trebuie sa afiseze un mesaj clar si sa raspunda cu status 200, nu sa genereze o pagina goala care poate fi perceputa ca soft-404.
- Linkuri interne catre paginile de cautare. Meniuri, breadcrumb-uri sau widget-uri de tip "cautari populare" care leaga direct catre URL-uri de cautare interna transmit autoritate (link equity) catre pagini care nu ar trebui sa fie in index.
- Parametri de cautare multiplicati. Filtre combinate cu termenul de cautare (sortare, pret, brand) pot genera zeci de variante de URL pentru aceeasi interogare — fara o regula clara de parametri, fiecare varianta devine un URL crawlabil separat.
- Sitemap.xml care include accidental URL-uri de cautare. Un generator de sitemap configurat gresit poate include automat orice URL accesat de crawler, inclusiv cautari interne — verifica periodic ca sitemap-ul contine doar pagini reale.
Plan practic de implementare
Pasii de mai jos acopera atat site-urile unde problema exista deja, cat si configurarea de la zero:
- Identifica tiparul exact de URL folosit de motorul de cautare intern (parametru, subfolder sau slug dedicat).
- Adauga
<meta name="robots" content="noindex, follow">in<head>-ul sablonului folosit de paginile de cautare, nu doar pe cele deja indexate. - Verifica in Google Search Console daca exista deja pagini de cautare indexate si cere eliminare din index dupa aplicarea noindex, folosind instrumentul de inspectie URL.
- Elimina orice link intern (meniu, widget, breadcrumb) care duce direct catre un URL de cautare interna.
- Configureaza
robots.txtpentru a bloca variantele cu parametri redundanti (sortare, filtrare combinata cu cautarea), dupa ce noindex a avut timp sa isi faca efectul. - Verifica sitemap.xml si elimina orice URL de cautare interna inclus accidental.
- Daca exista un caz de exceptie (cautare cu valoare comerciala reala, vezi sectiunea de mai sus), transforma acea cautare intr-o pagina de categorie dedicata, cu URL curat si continut propriu.
- Monitorizeaza in Search Console, timp de 4-8 saptamani, scaderea numarului de pagini de tip cautare din raportul de acoperire.
Cautare interna vs pagini de categorie: cand transformi una in cealalta
Diferenta esentiala este intentia din spatele URL-ului. O pagina de categorie exista indiferent de actiunea utilizatorului si are un set fix, previzibil de produse sau articole. O pagina de cautare exista doar ca raspuns la un input variabil si imprevizibil, introdus de oricine, oricand.
Cand observi in Search Console (inainte de a aplica noindex) ca anumite interogari de cautare interna genereaza trafic organic constant si relevant, cea mai buna decizie nu este sa le lasi indexate ca pagini de cautare, ci sa le "promovezi" la statutul de pagina de categorie permanenta: URL curat, H1 propriu, continut introductiv si linkuri interne normale catre ea. Asa pastrezi controlul editorial si tehnic complet asupra paginii, in loc sa lasi Google sa indexeze o pagina generata dinamic, fara continut stabil.
Intrebari frecvente despre SEO pentru paginile de cautare interna
Paginile de cautare interna trebuie mereu excluse din index?
In marea majoritate a cazurilor, da — pentru ca sunt generate dinamic, variaza in functie de input si nu au continut unic. Exceptia este cand o interogare specifica are trafic organic real si valoare comerciala clara; in acel caz, transformi cautarea intr-o pagina de categorie proprie, nu o lasi indexata ca rezultat de cautare.
Noindex afecteaza si utilizatorii care folosesc cautarea de pe site?
Nu. Tag-ul noindex influenteaza doar prezenta paginii in rezultatele Google. Functia de cautare interna ramane complet functionala pentru vizitatorii site-ului.
Robots.txt este suficient, fara noindex?
Nu. Robots.txt blocheaza accesul crawlerului, dar o pagina deja indexata sau cu linkuri externe poate ramane in index chiar fara sa fie recrawlata, fiindca Google nu mai vede tag-ul noindex daca accesul e blocat. Foloseste intai noindex, apoi, optional, robots.txt.
Canonical spre pagina de categorie rezolva singur problema?
Canonical este un semnal, nu o instructiune stricta — Google poate alege sa nu il respecte daca cele doua pagini nu sunt suficient de similare. Pentru pagini de cautare interna, noindex este solutia mai sigura si mai directa.
Cum verific rapid daca am pagini de cautare interna indexate acum?
Cauta in Google site:domeniultau.ro inurl: urmat de parametrul sau slug-ul folosit de functia de cautare (ex. inurl:?s= sau inurl:cauta). Orice rezultat aparut confirma ca exista pagini indexate care trebuie tratate.
Concluzie
Paginile de cautare interna nu trebuie sa concureze cu paginile reale ale site-ului pentru buget de crawlare si vizibilitate in index. Regula practica ramane simpla: noindex implicit pentru toate rezultatele de cautare generate dinamic, fara linkuri interne catre ele, si promovare la rangul de pagina de categorie doar pentru termenii care demonstreaza, cu date reale din Search Console, ca merita statutul de pagina permanenta.
Vrei sa verifici daca site-ul tau are pagini de cautare interna indexate din greseala? Discutam un audit tehnic.
Imagine generata cu AI, folosita in scop ilustrativ.
Scrie un comentariu