 EN
 RO
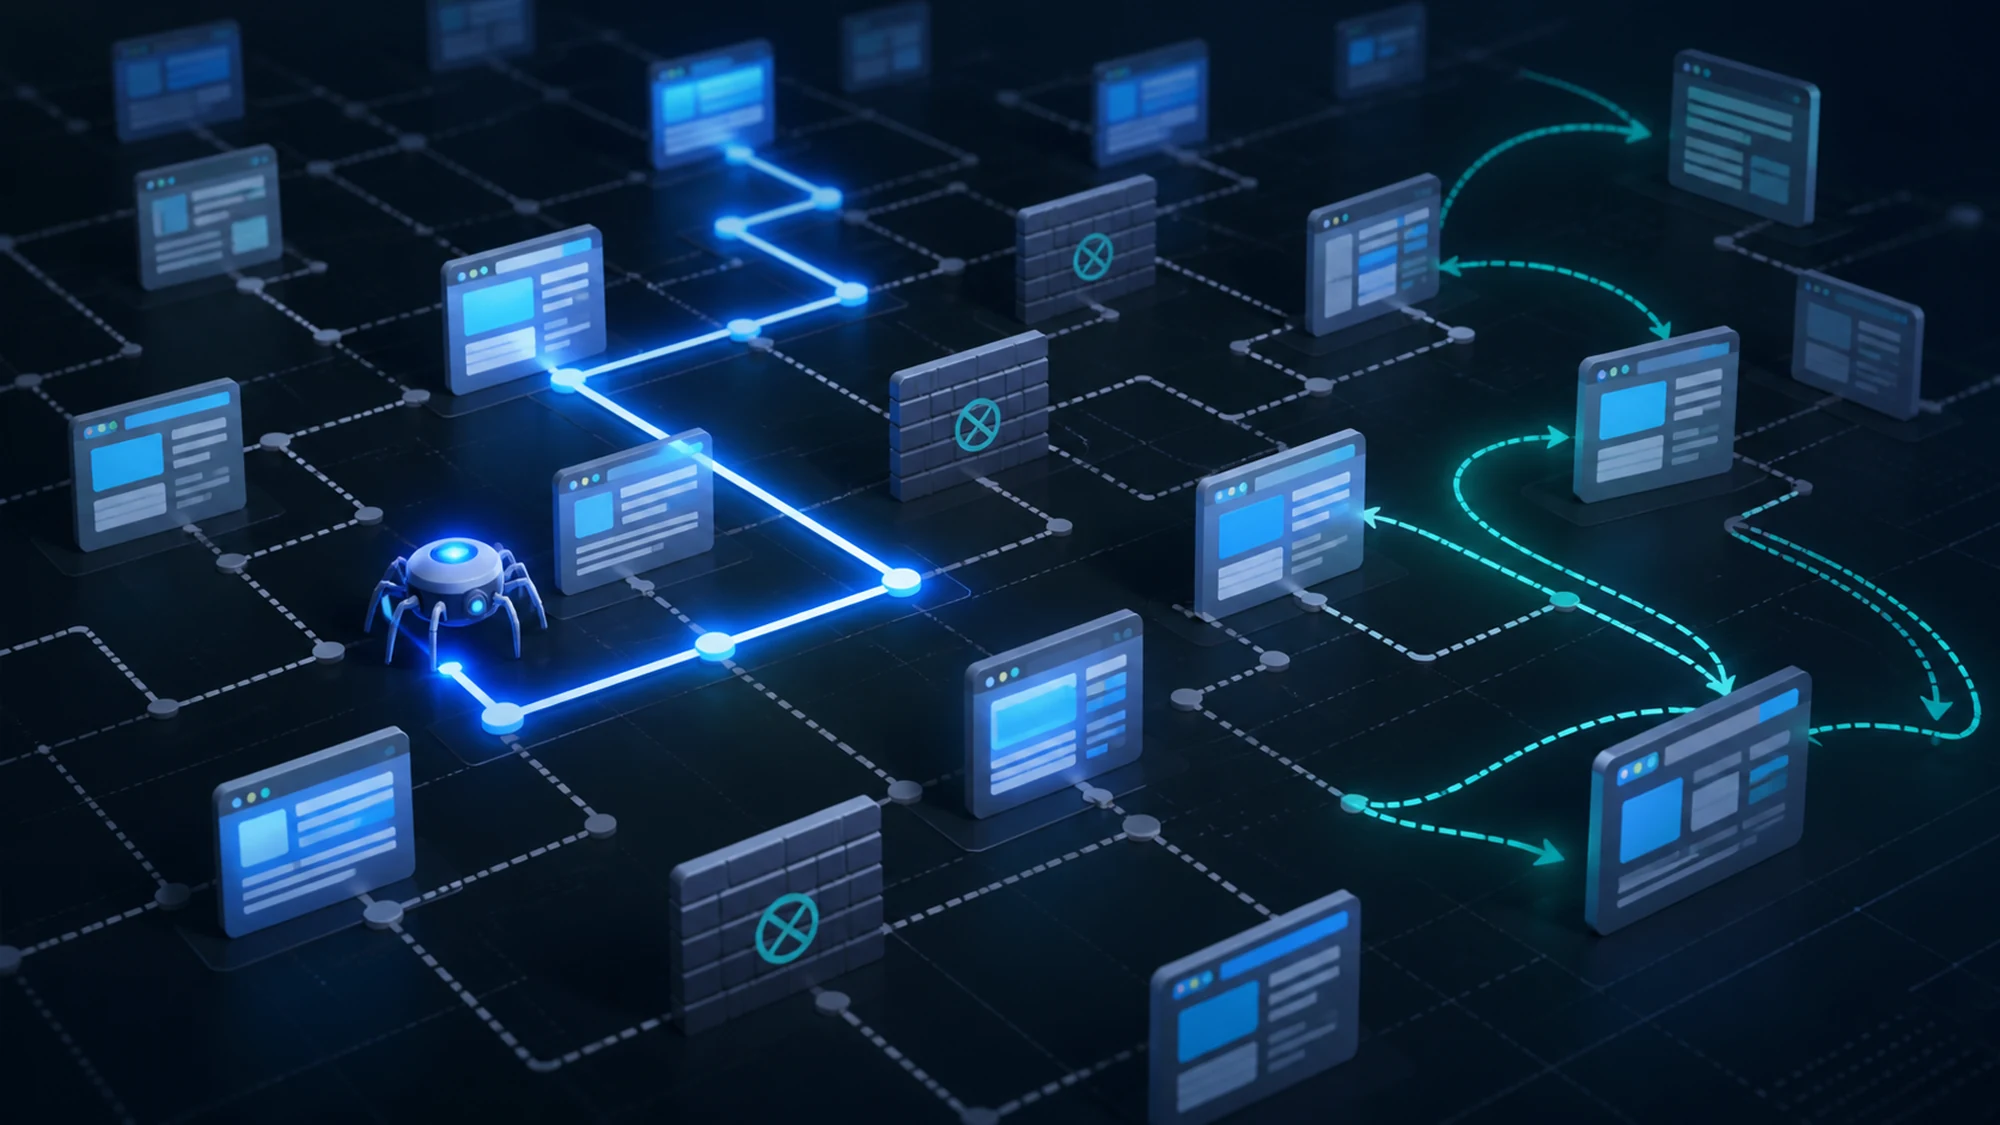
Pe un site cu cateva zeci de pagini, Google are timp sa le viziteze pe toate, indiferent cat de ordonata este structura. Pe un site cu zeci sau sute de mii de URL-uri – magazine online cu filtre si paginare, portaluri cu continut generat automat, site-uri multi-limba – lucrurile stau diferit: Googlebot aloca un buget limitat de vizite pentru fiecare domeniu, iar acel buget se poate irosi pe pagini fara valoare, in timp ce paginile importante raman necrawlate sau neactualizate.
Bugetul de crawlare (crawl budget) nu este o setare pe care o activezi dintr-un panou; este rezultatul combinat al modului in care folosesti robots.txt, tag-ul canonical si directivele de indexare pentru a ghida Googlebot spre URL-urile care conteaza si a-l tine departe de variantele duplicate sau de valoare mica.
Acest ghid explica ce inseamna concret bugetul de crawlare, cum se combina robots.txt cu canonical si noindex, care sunt cele mai frecvente surse de continut duplicat pe site-uri mari si cum verifici, cu date reale din Search Console, daca Google iti crawleaza site-ul eficient.
Ce este bugetul de crawlare si cand conteaza cu adevarat
Bugetul de crawlare este numarul de URL-uri pe care Googlebot este dispus si capabil sa le viziteze pe un domeniu intr-o perioada data. Google il descrie prin doi factori combinati: limita de rata de crawlare (cate cereri poate trimite serverul tau fara sa il incarce excesiv) si cererea de crawlare (cat de mult vrea Google sa iti actualizeze continutul, in functie de popularitate si frecventa modificarilor).
Pentru majoritatea site-urilor mici si medii, bugetul de crawlare nu este o problema practica: Google reuseste sa acopere toate paginile importante fara interventie speciala. Devine relevant cand numarul de URL-uri unice depaseste cu mult numarul de pagini care aduc valoare reala – situatie tipica pentru eCommerce cu filtre combinabile, site-uri cu parametri de tracking in URL, arhive generate automat sau portaluri multi-limba fara canonicalizare corecta.
Semnul cel mai clar ca ai o problema de buget de crawlare este cand pagini noi sau actualizate importante raman necrawlate zile sau saptamani, in timp ce raportul de crawlare din Search Console arata mii de cereri catre URL-uri cu parametri sau variante duplicate ale acelorasi pagini.
Cum controlezi crawlarea cu robots.txt (si ce nu poate face acest fisier)
Fisierul robots.txt, plasat la radacina domeniului, spune crawlerelor ce cai de pe site nu ar trebui sa le viziteze. Este un instrument de crawlare, nu de indexare – distinctie esentiala si frecvent inteleasa gresit.
- O regula
Disallowin robots.txt opreste Googlebot sa mai descarce acea cale, deci economiseste buget de crawlare pentru sectiuni fara valoare (ex: rezultate de cautare interna, parametri de sortare, panouri de administrare). - Robots.txt nu garanteaza ca o pagina blocata nu va aparea in Google. Daca pagina este blocata dar are linkuri externe catre ea, Google poate afisa totusi URL-ul in rezultate, fara titlu sau descriere, pentru ca nu a putut-o crawla ca sa vada continutul.
- Nu folosi robots.txt pentru a bloca pagini pe care vrei sa le scoti explicit din index; pentru asta foloseste
noindex, care necesita insa ca pagina sa fie crawlabila pentru ca Google sa vada directiva.
Regula practica: robots.txt este pentru economisirea bugetului de crawlare pe sectiuni cu volum mare si valoare mica (fatete infinite, cautare interna, parametri de sesiune), nu pentru controlul fin al indexarii unor pagini individuale.
Canonical tags: cum previi continutul duplicat fara sa blochezi crawlarea
Tag-ul <link rel="canonical"> spune Google care este versiunea "oficiala" a unei pagini atunci cand exista mai multe URL-uri cu continut identic sau aproape identic. Spre deosebire de robots.txt, canonical nu opreste crawlarea – Google tot viziteaza varianta duplicata, dar consolideaza semnalele (linkuri, relevanta) catre URL-ul canonic.
Cazuri tipice pe site-uri mari unde canonical previne continutul duplicat:
- Parametri de tracking sau sesiune (
?utm_source=,?sessionid=): URL-ul canonic trimite catre versiunea fara parametri. - Variante de sortare si filtrare care nu schimba fundamental continutul (
?sort=pret_crescator): canonical catre pagina de categorie de baza, cu exceptia filtrelor care merita propria pagina indexabila (vezi sectiunea urmatoare). - Versiuni HTTP/HTTPS sau www/non-www ramase active din greseala: canonical (impreuna cu un redirect 301, ideal) catre versiunea finala.
- Continut sindicat sau republicat pe mai multe subdomenii sau limbi fara hreflang corect: canonical clar catre sursa originala.
Un canonical setat gresit – de exemplu catre o pagina irelevanta sau catre homepage – poate face mai mult rau decat lipsa lui, pentru ca Google poate ignora pagina reala in favoarea tintei canonicalizate incorect. Verifica intotdeauna ca fiecare pagina indexabila are un canonical auto-referential corect, nu doar o valoare copiata dintr-un sablon.
Robots.txt vs. noindex vs. canonical: cand folosesti fiecare
Cele trei mecanisme rezolva probleme diferite si se combina gresit foarte des pe site-urile mari. Confuzia cea mai frecventa: blocarea prin robots.txt a unei pagini care are deja noindex – in acest caz Google nu mai poate vedea directiva noindex, pentru ca nu are voie sa crawleze pagina, iar rezultatul poate fi exact opusul intentiei.
| Directiva | Opreste crawlarea? | Opreste indexarea? | Cand o folosesti |
|---|---|---|---|
| robots.txt (Disallow) | Da | Nu garantat | Economisire buget de crawlare pe sectiuni fara valoare (cautare interna, parametri de sesiune, admin) |
| Meta robots noindex | Nu | Da (daca pagina e crawlabila) | Pagini care trebuie sa ramana accesibile, dar scoase explicit din index (pagini de filtrare cu continut subtire, pagini duplicate temporar) |
| Canonical | Nu | Consolideaza, nu blocheaza | Continut duplicat sau aproape duplicat, unde vrei sa pastrezi semnalele pe o singura versiune canonica |
| Redirect 301 | Nu (redirectioneaza) | Da, catre tinta | URL-uri vechi, mutate definitiv, fara nicio nevoie sa mai existe ca pagina separata |
Regula de decizie rapida: daca pagina nu trebuie sa mai existe deloc pentru vizitatori, foloseste redirect 301. Daca trebuie sa existe, dar e o varianta a unei pagini principale, foloseste canonical. Daca trebuie sa existe pentru vizitatori dar nu pentru index, foloseste noindex, nu robots.txt. Robots.txt ramane rezervat pentru sectiuni intregi, cu volum mare, pe care nu vrei sa le crawleze deloc.
Cele mai frecvente surse de continut duplicat pe site-uri mari
Continutul duplicat la scara mare rareori apare intentionat – este de obicei un efect secundar al functionalitatilor tehnice adaugate fara sa se tina cont de impactul asupra numarului de URL-uri unice generate.
- Filtre combinabile in eCommerce (marime + culoare + brand) pot genera mii de combinatii de URL pentru acelasi set de produse, majoritatea fara volum de cautare propriu.
- Paginare fara strategie clara: fiecare pagina dintr-o lista lunga (pagina 2, 3, 4...) poate deveni continut aproape identic daca nu are un scop de indexare distinct.
- Parametri de sesiune sau de afiliere pastrati in URL in loc de cookie sau header, multiplicand acelasi continut sub URL-uri diferite.
- Versiuni pentru print sau mobil separate, ramase din arhitecturi vechi, care dubleaza continutul unei pagini deja existente.
- Continut generat automat din surse comune (descrieri de producator, fise tehnice identice pe mai multe site-uri sau categorii) fara diferentiere editoriala.
Nu toate combinatiile de filtre trebuie blocate sau canonicalizate identic: o combinatie cu volum real de cautare (ex: "pantofi barbati piele negri") poate merita propria pagina indexabila, in timp ce combinatii rare sau redundante ar trebui canonicalizate catre categoria de baza.
Cum verifici in Search Console daca Google iti risipeste bugetul de crawlare
Verificarea nu trebuie sa fie o presupunere; Search Console ofera date directe despre ce si cat crawleaza Google pe domeniul tau.
- Raportul de statistici de crawlare (Crawl Stats, in setarile de proprietate) arata numarul total de cereri, defalcat pe tip de fisier si pe raspuns HTTP. Un procent mare de cereri catre URL-uri cu parametri sau catre raspunsuri 404/soft-404 este semn de buget irosit.
- Raportul "Pagini" arata cate URL-uri sunt in starea "Descoperit – in prezent neindexat" (Google le stie, dar nu a apucat sau nu a considerat necesar sa le crawleze) – un volum mare aici, pe pagini importante, indica presiune pe bugetul de crawlare.
- Categoria "Duplicat, Google a ales alt canonical decat cel al utilizatorului" din acelasi raport arata exact unde Google a ignorat canonical-ul tau si a ales alta versiune – semnal clar ca structura de canonicalizare are nevoie de corectii.
- Fisierul de log al serverului (server log analysis), cand este disponibil, arata exact ce URL-uri viziteaza Googlebot si cu ce frecventa, oferind o imagine mai precisa decat esantionul din Search Console.
Plan practic de implementare (checklist)
- Extrage din Search Console raportul de statistici de crawlare si identifica sectiunile cu volum mare de cereri fara valoare de indexare.
- Adauga in robots.txt reguli explicite pentru sectiunile fara valoare (cautare interna, parametri de sesiune, panouri interne), fara sa blochezi resurse necesare randarii.
- Verifica pentru fiecare tip de pagina indexabila ca tag-ul canonical este auto-referential corect, nu preluat dintr-un sablon gresit.
- Stabileste explicit, pe fiecare tip de filtru combinabil, daca merita pagina indexabila proprie (volum de cautare real) sau canonical catre categoria de baza.
- Inlocuieste, unde e posibil, parametrii de tracking din URL cu metode care nu genereaza URL-uri noi (cookie, UTM procesat server-side).
- Foloseste noindex, nu robots.txt, pentru pagini care trebuie sa ramana crawlabile dar excluse din index.
- Monitorizeaza lunar raportul "Pagini" pentru cresteri ale volumului "Descoperit – in prezent neindexat" sau al conflictelor de canonical.
Riscuri frecvente si cum le previi
- Blocarea in robots.txt a unei pagini cu noindex: Google nu mai poate vedea directiva noindex, iar pagina poate ramane indexata cu informatii minime. Mitigare: lasa pagina crawlabila si foloseste doar noindex.
- Canonical catre o pagina care redirectioneaza sau da 404: semnal contradictoriu care poate face Google sa ignore canonical-ul complet. Mitigare: verifica periodic ca URL-urile canonice raspund cu status 200.
- Blocarea resurselor JS/CSS in robots.txt: impiedica randarea corecta a paginii de catre Google, chiar daca HTML-ul de baza este accesibil. Mitigare: permite explicit accesul la fisierele necesare randarii.
- Sitemap XML care include URL-uri deja canonicalizate catre alta pagina: trimite un semnal contradictoriu – sitemap-ul ar trebui sa contina doar URL-urile canonice. Mitigare: genereaza sitemap-ul din aceeasi sursa de date care determina canonical-ul, nu separat.
- Modificarea robots.txt fara testare prealabila: o regula prea larga poate bloca din greseala sectiuni intregi cu valoare reala. Mitigare: testeaza orice regula noua cu instrumentul de testare robots.txt din Search Console inainte de a o publica.
Intrebari frecvente despre robots.txt, canonical si crawl budget
Blocarea unei pagini in robots.txt garanteaza ca ea nu mai apare in Google?
Nu. Robots.txt opreste doar crawlarea, nu indexarea directa. Daca pagina blocata are linkuri externe catre ea, Google poate afisa totusi URL-ul in rezultate, fara titlu sau descriere, pentru ca nu are voie sa citeasca continutul. Pentru excludere garantata din index, foloseste noindex pe o pagina care ramane crawlabila.
Cat de mare trebuie sa fie un site ca sa aiba nevoie de gestionare activa a bugetului de crawlare?
Nu exista un prag fix in numar de pagini; conteaza raportul dintre URL-uri unice generate si pagini cu valoare reala de indexare. Un magazin online cu cateva mii de produse, dar cu filtre combinabile ce genereaza sute de mii de URL-uri, poate avea nevoie de gestionare activa mai devreme decat un site editorial cu zeci de mii de articole unice.
Canonical si redirect 301 fac acelasi lucru?
Nu. Redirect 301 trimite vizitatorul si crawlerul fizic catre alt URL, iar pagina originala nu mai este accesibila separat. Canonical lasa ambele pagini accesibile, dar spune motorului de cautare care versiune sa consolideze si sa afiseze in rezultate. Foloseste 301 cand pagina veche nu mai trebuie sa existe deloc, canonical cand variante multiple trebuie sa ramana functionale.
Merita sa blochez toate paginile de filtrare in robots.txt?
Nu automat. Unele combinatii de filtre au volum de cautare real si merita sa fie indexabile, cu propriul continut si canonical auto-referential. Blocarea nediferentiata a tuturor paginilor de filtrare poate elimina din index pagini care ar fi adus trafic organic real. Analizeaza volumul de cautare inainte de a decide, filtru cu filtru sau categorie de filtre.
Cat de des trebuie revizuita strategia de robots.txt si canonical pe un site mare?
Ca reper practic, o revizuire la fiecare 3-6 luni, plus imediat dupa orice modificare majora de structura (relansare de site, adaugare de filtre noi, migrare de platforma). Raportul de statistici de crawlare din Search Console arata rapid daca modificarile recente au avut efectul dorit asupra distributiei bugetului de crawlare.
Concluzie
Gestionarea bugetului de crawlare pe un site mare nu inseamna sa blochezi cat mai mult, ci sa folosesti robots.txt, canonical si noindex pentru rolurile pentru care au fost create, fiecare separat: robots.txt pentru sectiuni intregi fara valoare, canonical pentru consolidarea variantelor duplicate, noindex pentru pagini care trebuie sa ramana accesibile dar in afara indexului. Combinate gresit, aceste mecanisme se anuleaza reciproc; combinate corect, elibereaza bugetul de crawlare exact pentru paginile care conteaza pentru afacerea ta.
Ai un site mare cu pagini importante care intarzie sa fie crawlate sau indexate? Discutam un audit tehnic al bugetului de crawlare.
Scrie un comentariu